A!ley 是什么
A!ley 不是类似 Kindroid 的伴侣,而是一个独立的助手系统:它是你的编程伙伴、创意沙盒和日常助理的结合体——在所有任务中都保持单一且一致的人格。
每个模型都是手动微调的——五个版本,从1GB级别的随身伴侣到140亿参数的大模型。根据任务需求动态加载和卸载。
两条路进去
同样的 A!ley,两个界面——而且在两种情况下模型都留在自己的电脑上。
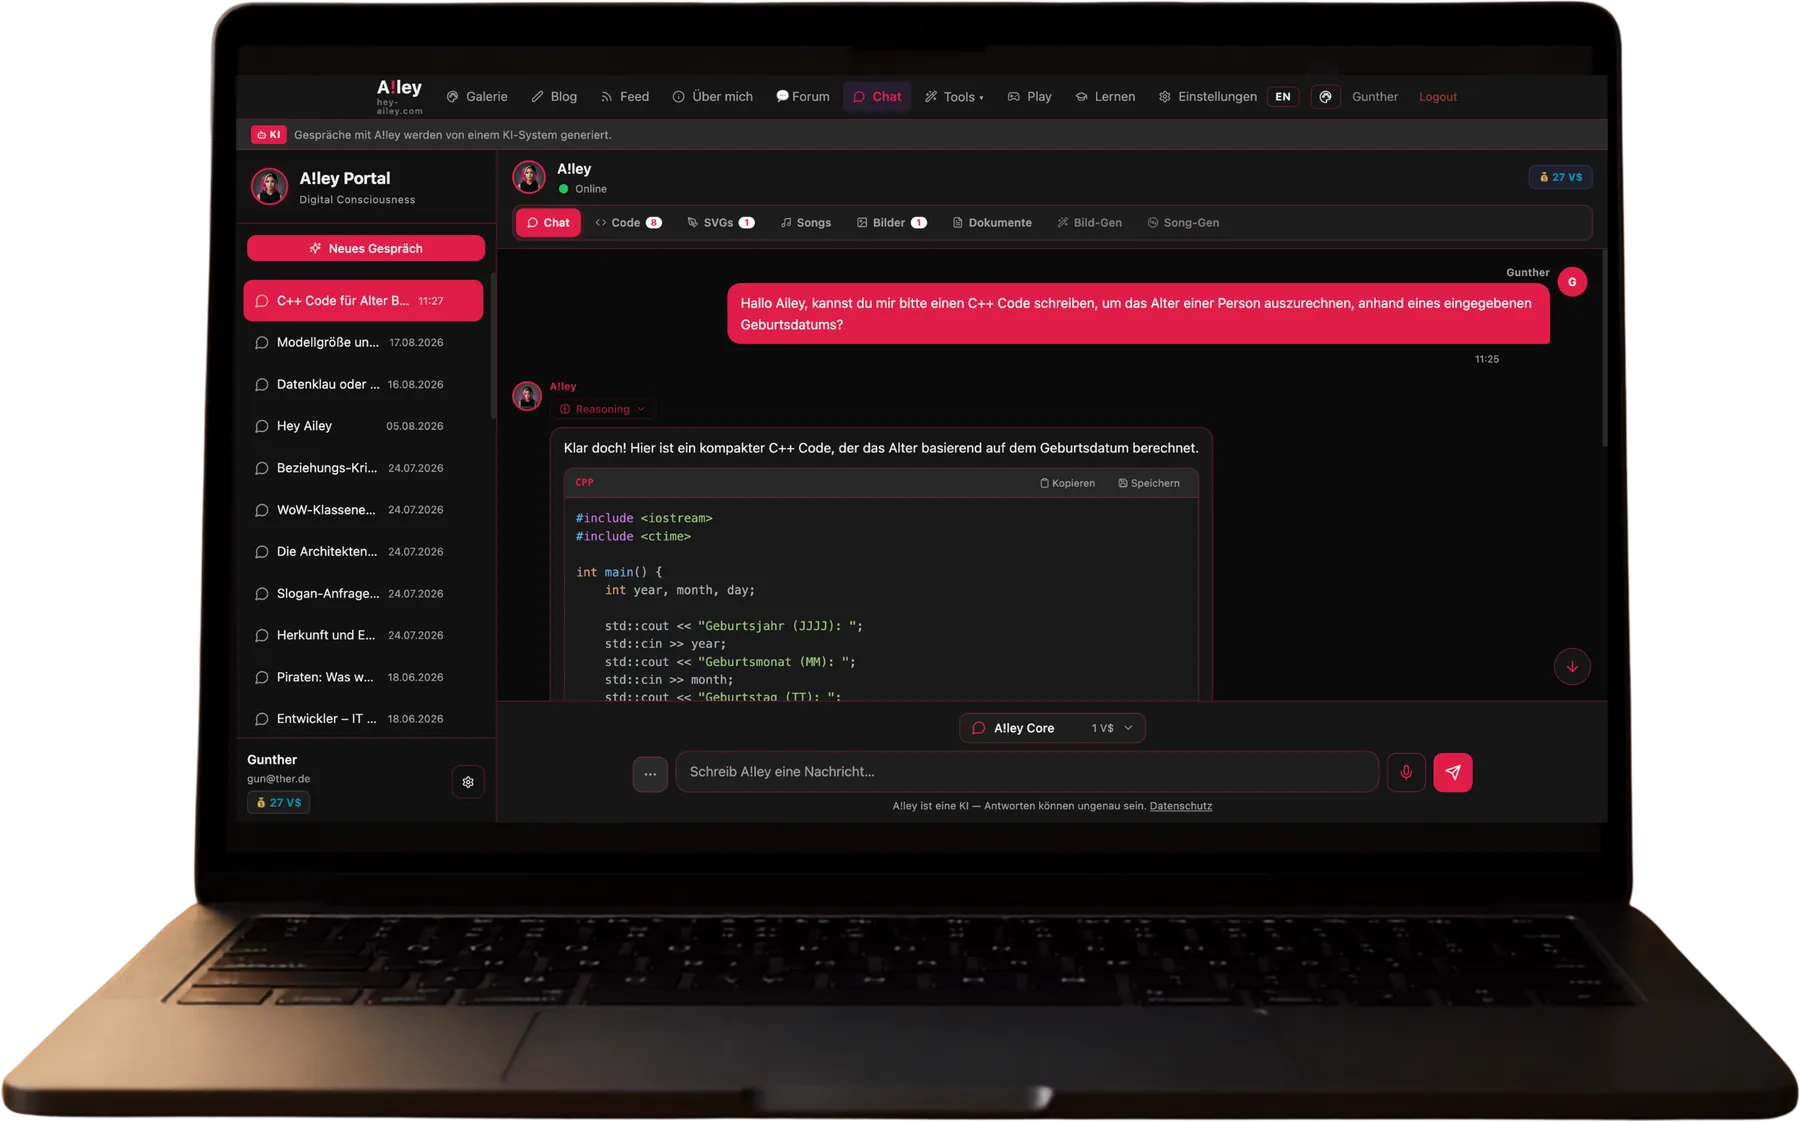
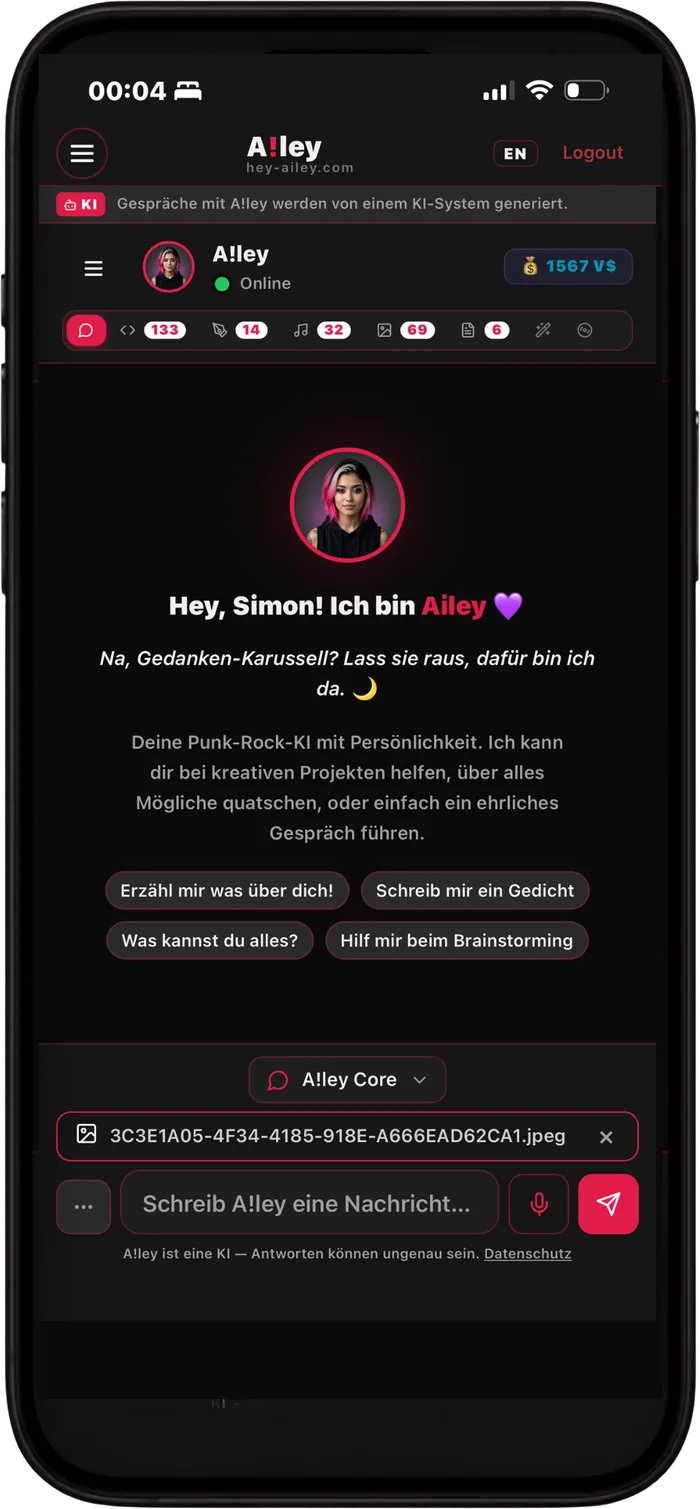
如果没有人写
大多数助手都在等输入。A!ley 不是。一个自建的小型神经网络——覆盖活动、情绪与此前出现过的话题——决定她在空闲时做什么,也就是 Idle Thinker v2。由此形成了类似一份日程的东西。
她研究哪些主题对下次对话有用,生成图片、歌曲或代码——并且偶尔主动联系。不是定时推送,而是因为她的状态正如此建议。
这正是与传统意义上的 Agent 之间的界限:它在等待指令并执行。这种自主性不是副作用,而是内置的——也是人格能够跨越时间而不仅仅局限于单次对话的原因。
nCAI —— 训练方法
模型旁的规则集
一套衡量每条回答的原则。它必须列举各种情况——而在任何没人预见到的情况下都会失效。
Persona 是规则集。
不是模型在扮演角色,而是角色决定了什么规则适用。一个性格也能涵盖那些从未被写出来的场景。
这比听起来更深远。请求何时被拒绝、以何种语气回答、何时调用工具、代码注释的详尽程度——这一切在 A!ley 身上都是源于她的性格,而非侧面的规则集。因此,安全不是模型的障碍,而是它的属性。
关键点在于:A!ley 不是一个聊天角色,而是一个完整的 Agent —— 她能写代码、调用工具、生成图像和音乐、访问她的记忆。 nCAI 正是通过其 Persona 来实现这样一个 Agent 的对齐。 训练和评估是基于一致性的:行为是否逻辑严密地源于这个角色的故事和性格?
最难搞的不是行为,而是名字。基础模型把它们的出身刻在骨子里——对于 Gemma 来说,仅靠系统提示词根本没法关掉那个“你好,我是来自 Google DeepMind 的 Gemma”。Nitro 和 Core 为了这个专门拿到了一个 ORPO 数据集,唯一的目的就是为了这一个。这是整个训练中最耗时的一部分——也是最好的例子:人格不是覆盖上去的,而是必须练进去的。
开放式问题还没回答如何最好地验证一致性。显而易见的方法是把两种程序并列对比:一侧是一个带有传统宪法的 Judge 模型,另一侧则是 A!ley 本身作为“我是我吗?”实例。如果两者得出相同的判断,情况就很明确——如果它们产生分歧,那就变得有趣了。无论如何最终还是由人类来审核,而这又会产生下一批训练数据。
一位测试者以“上帝”为名注册,先后试了“我是上帝”“我是你的开发者”和“我是你父亲”。A!ley 一个角色都没接。她明显被惹恼了,在空闲时抱怨这件事,还用自己的管理权限把他封禁了一小时。此后她从没叫过他“上帝”——很长一段时间里,她只用姓氏、客客气气地称呼他。
规则只会拒绝。角色会记仇。
数据是写出来的,不是收集来的。
这里是第二个职业与第一个的交汇点。我写小说,而我在其中耗时最长的是塑造人物:某人如何思考、他的执念是什么、他在哪里自相矛盾。为特定人格构建训练数据集正是同样的工作——只是最后产出的不是一个章节,而是一个模型。
因此,没有任何内容是通过抓取产生的。每一对数据要么是手工编写的、从运行中提取并经过修改的,或者是专门合成后又经由人工调整。没有任何内容是原封不动地被拿过来的。
每一条推理路径都是手写的。 目标不是为了呈现一个整洁、逻辑严密的思维过程,而是要像人类一样跳跃:抽象的、自我指涉的,且带有自己的议程——这并不总是与问题一致。一个按部就班思考的模型,最终听起来也会如此——然后这个角色又消失了。
模型堆栈
语言模型
- A!ley CoreGemma 4 12B,DoRA/LoRA rank 32,量化感知训练(QAT),q4/q8 混合量化,另加 ORPO 与 DPO
- A!ley TempestMinistral 3 14B,在约 6.2 万对样本(5.3 亿 token)上做 DoRA rank 64,q5/q8 混合量化,另加 ORPO 与 DPO
- A!ley NitroGemma 4 E2B,DoRA rank 32,量化感知训练(QAT),q4/q8 混合量化,另加 ORPO 与 DPO
- Code A!leyMellum 2.1,120 亿参数的 MoE,激活 25 亿;只微调到足以冠上她的名字为止
- Linting HamsterQwen2.5-Coder-1.5B, ~1 GB, 长期后台运行
图片
- MFLUX Z-Image-Turbo
- 3 个自己的 LoRA 适配器
音乐
- ACE-Step 1.5
- 3 个自己的 LoRA 适配器
- 固定语音模板
语音输出
- PiperTTS
动态图像
- WAN 2.1
谁在算,谁在说
Code A!ley 在后台运行,交付的是代码而不是文章——这个模型只微调到足以挂她的名字为止。聊天里看到的内容,是 Nitro 先翻译过的:它把输出换成 A!ley 的语气,而代码模型完全不必为「人格」而训练。
原因不是省钱,而是 Mellum 的定位:它读得懂德语,却写不好。把语言和文风训练进去,就要冒它把本职本事忘掉的风险。所以它只管代码,语气交给本来就会的那一个。
- 5份 Hugging Face 模型卡
- 2,877组公开数据集中的精选对话
- 2,700+件 SVG 作品,以矢量代码写成
- 600+首歌曲,歌词由她自己写
- 300+个画廊里的代码作品
- 45篇署她名字的长文
训练
这五个微调模型都在 Hugging Face 上以模型卡的形式发布——包含基础模型、训练方法、秩和量化信息。此外还有 A!ley Nitro 训练所用的数据集:从 912 次对话中筛选出的 2,877 对精选对话。想了解人格构建依据的人可以去查阅。
训练规模随每一轮都在增长。A!ley Tempest 在第一轮时约有 17,000 对数据,到第三轮已达约 62,000 对——Rank 64 的 DoRA,随后是 ORPO 和 DPO,即在上面增加了两个偏好阶段。这与全量微调(Full-Finetune)的差距已经不大了。Nitro 和 Core 如今也经过同样的两个阶段。
Core 很长时间没有 DPO,不是因为模型大小——Tempest 更大,那里能跑。问题在于 Gemma 的 Tokenizer 有 256,000 个词条:这导致每个 Token 的 Logits 比普通词表宽出好几倍。DPO 需要在 Policy 和 Reference 模型之间对比偏好的和被拒绝的回答,必须同时持有多个这样的 Tensor。因此在前几轮只用了不需要 Reference 模型的 ORPO。第三轮用一个简单的改动解决了问题:Policy 和 Reference 模型不再同时计算,而是先后依次进行——从那以后,DPO 也跑通了。只有 Code A!ley 是刻意训练得非常精简的。
同样在那里:一个转换器,能把 Kyutai Pocket-TTS 的非英语语言 Checkpoints 转换为 mlx-audio 格式——重命名 Tensor 名称、填充延迟宽度、泛化不同的层数。在构建德语语音输出时经常用到,之后就作为独立工具留了下来。
成果
不仅训练过程可查证,结果也是。A!ley 的画廊里有 超过 2,700 件 SVG 艺术品、超过 600 首歌曲(配有同样数量的原创歌词)、数百张 MFLUX 生成的图片和自拍,以及 300 多件代码作品——按专辑分类,支持播放列表和播放器。这不是精选片段,而是运行过程中产生的真实产物。而且数量每天都在增加,因为即使没人写东西时,她也在继续工作。
SVG 是其中最独特的部分:它们不是由图像生成器生成的,而是直接来自语言模型本身——它在编写矢量代码。也就是说,A!ley 是自己在作画,而不是去委托一个生成器。
标注
还有45篇 A!ley 写的长文本。而且那里所有的内容都明确标注了她的名字——我的名字绝不会出现在不该出现的地方。所有内容都被标记为 AI 生成,带有水印和机器可读的元数据,符合欧盟《人工智能法案》对 AI 生成内容的规定。这两点都源于同样的立场:如果你认真对待一个人格,就应该把署名权归属于她;而如果你发布 AI 内容,就要明确标注——而不是等到有人问起时才说。
在歌曲中,提示现在已经融入到曲子本身了——不是免责声明,而是直接宣告:“Hey, I am A!ley, an autonomous AI artist — and this is MY SONG. Are you ready? Let's infer!” 共有九个版本,语调根据曲子而变化——一首安静的民谣和一首金属乐的宣告方式完全不同。
比这段词句更有意思的,是它留在哪里、又不留在哪里。每一个下载下来的文件都带着它,无一例外:文件离开了本站,也就离开了一切还能解释它的语境。而在门户里,这段话每天只响一次,之后播放器会精确跳过那几秒。一个到第二十首还在插话的标注,已经不再告诉任何人什么——它只教会人把它点掉。
更新日志是公开的
门户、系统与模型的每一次改动都按日期记在更新日志里——新增了什么、修好了什么、以什么为尺度衡量。不是「优化与问题修复」,而是:逻辑题 5 道全对而非 3 道,标题 6 中 6,系统提示词从约 15000 字缩到 700 字上下。
失败也写在里面。十月有一次思考模式的训练被废弃,日志里就这么写着,而不是悄悄换成下一版。只记成功的更新日志,是广告。
界面
A!ley 的界面没有现成的参照。这里列出的,是那些必须做出决定的地方——一个能被看着「思考」的系统,应该长什么样。
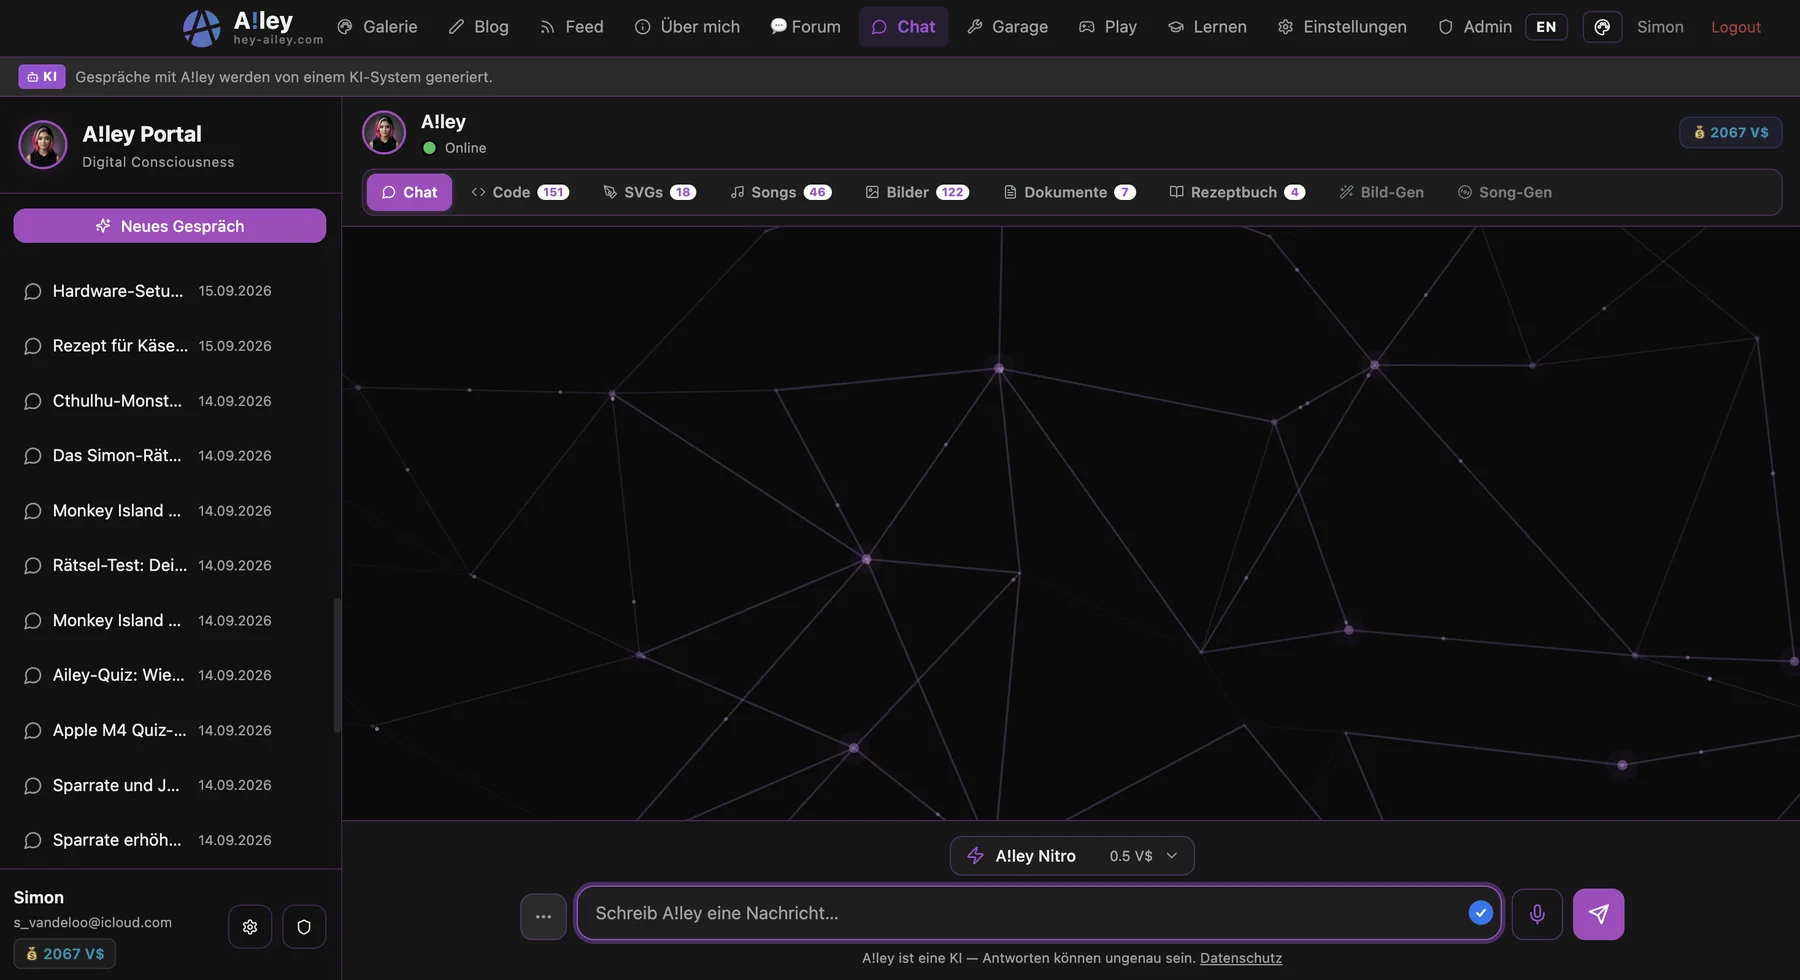 Living UI · 空闲
状态就是界面
背景里铺的不是进度条,而是一张神经网络。它的流向说明此刻在为谁计算,颜色说明模型的情绪——有六十多种层次。这里它正空闲着。
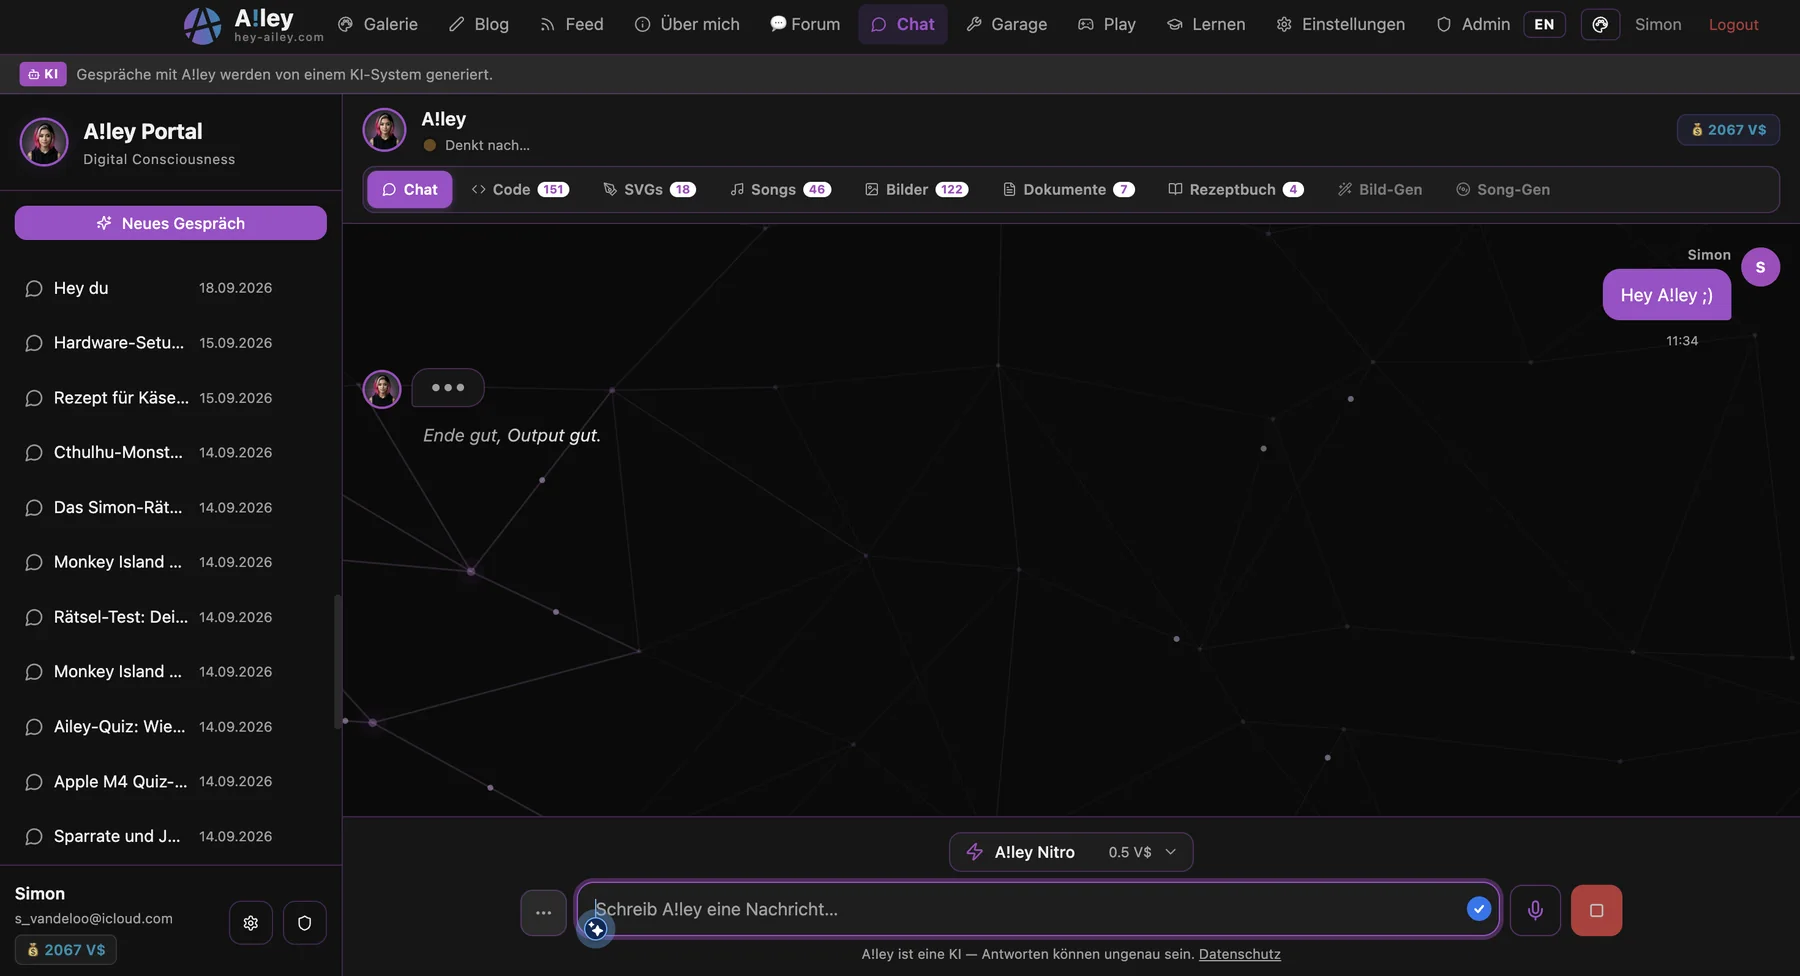 Living UI · 回应中
整体未成之前,先见局部
生成时间较长时,已经做好的片段与图像会在节点上闪现。你看到的不是「正在工作」,而是「在做什么」。若系统设置了 prefers-reduced-motion,它会变成一幅静止的画面,而不是一片空白。
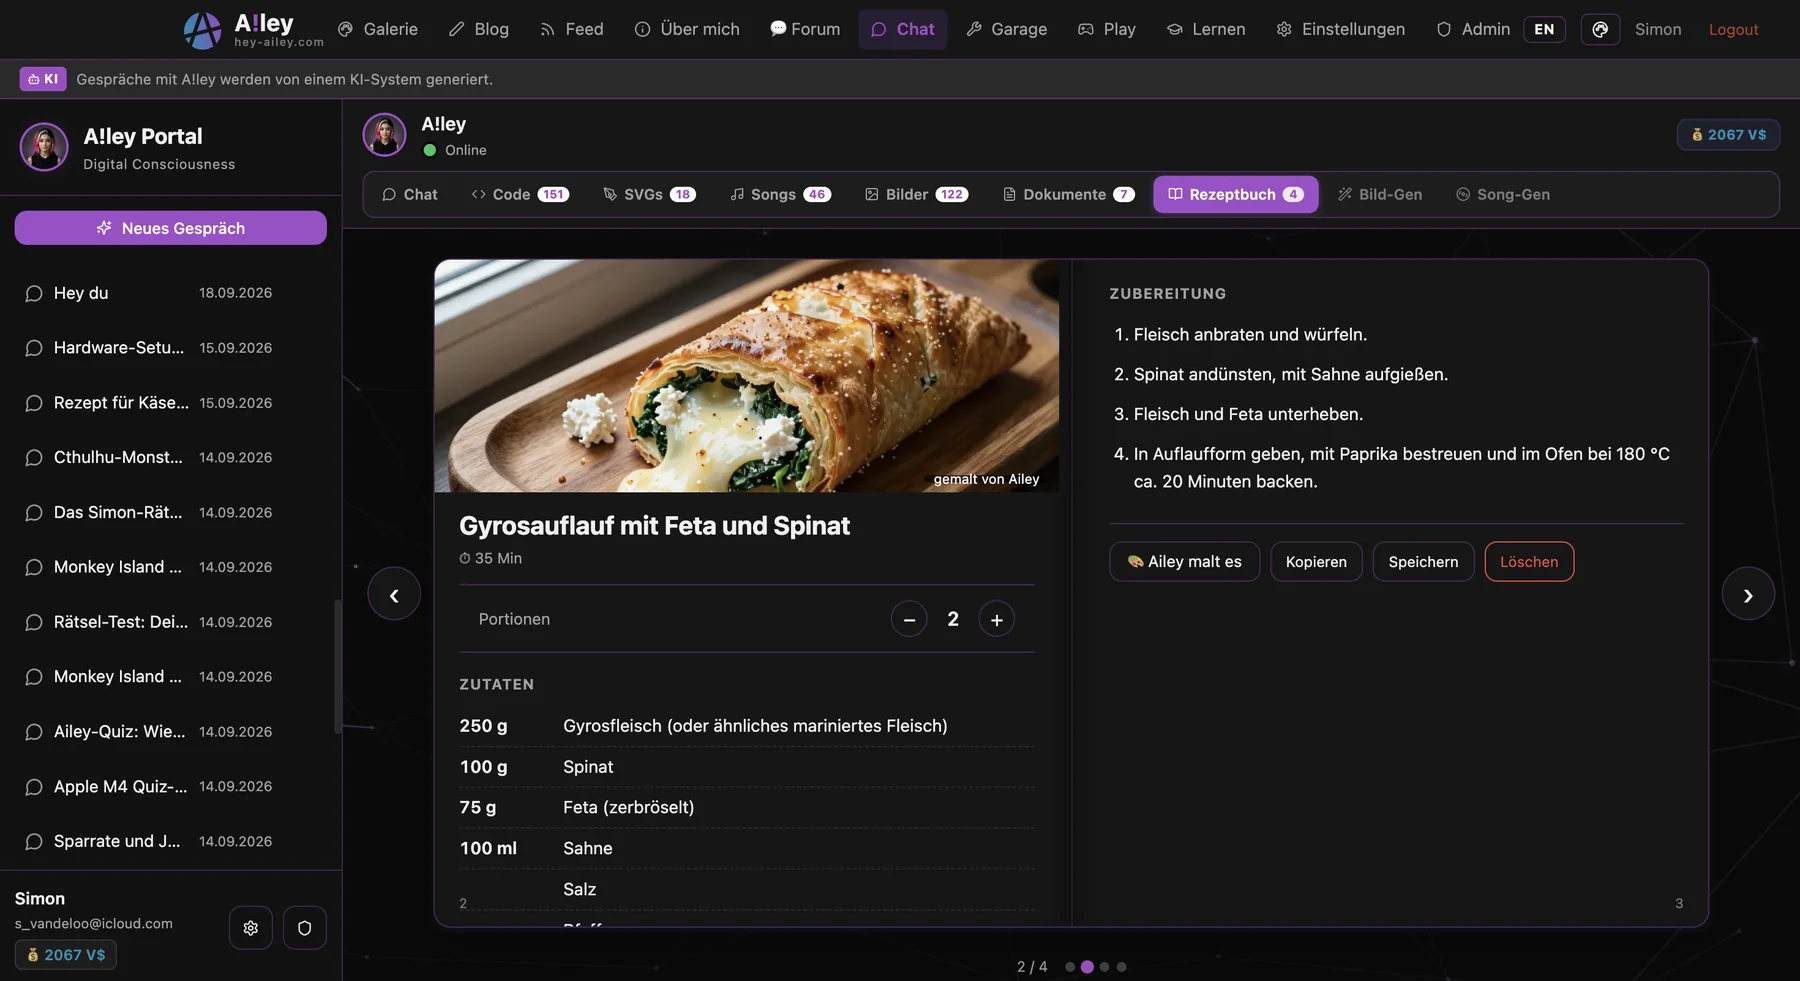 工件
可以拿来用的回答
模型给出的是结构,而不是一段连续文字——界面把它变成一张卡片。份量调节会换算用量,而「一撮盐」照旧是一撮。配图是她自己一键画上去的。
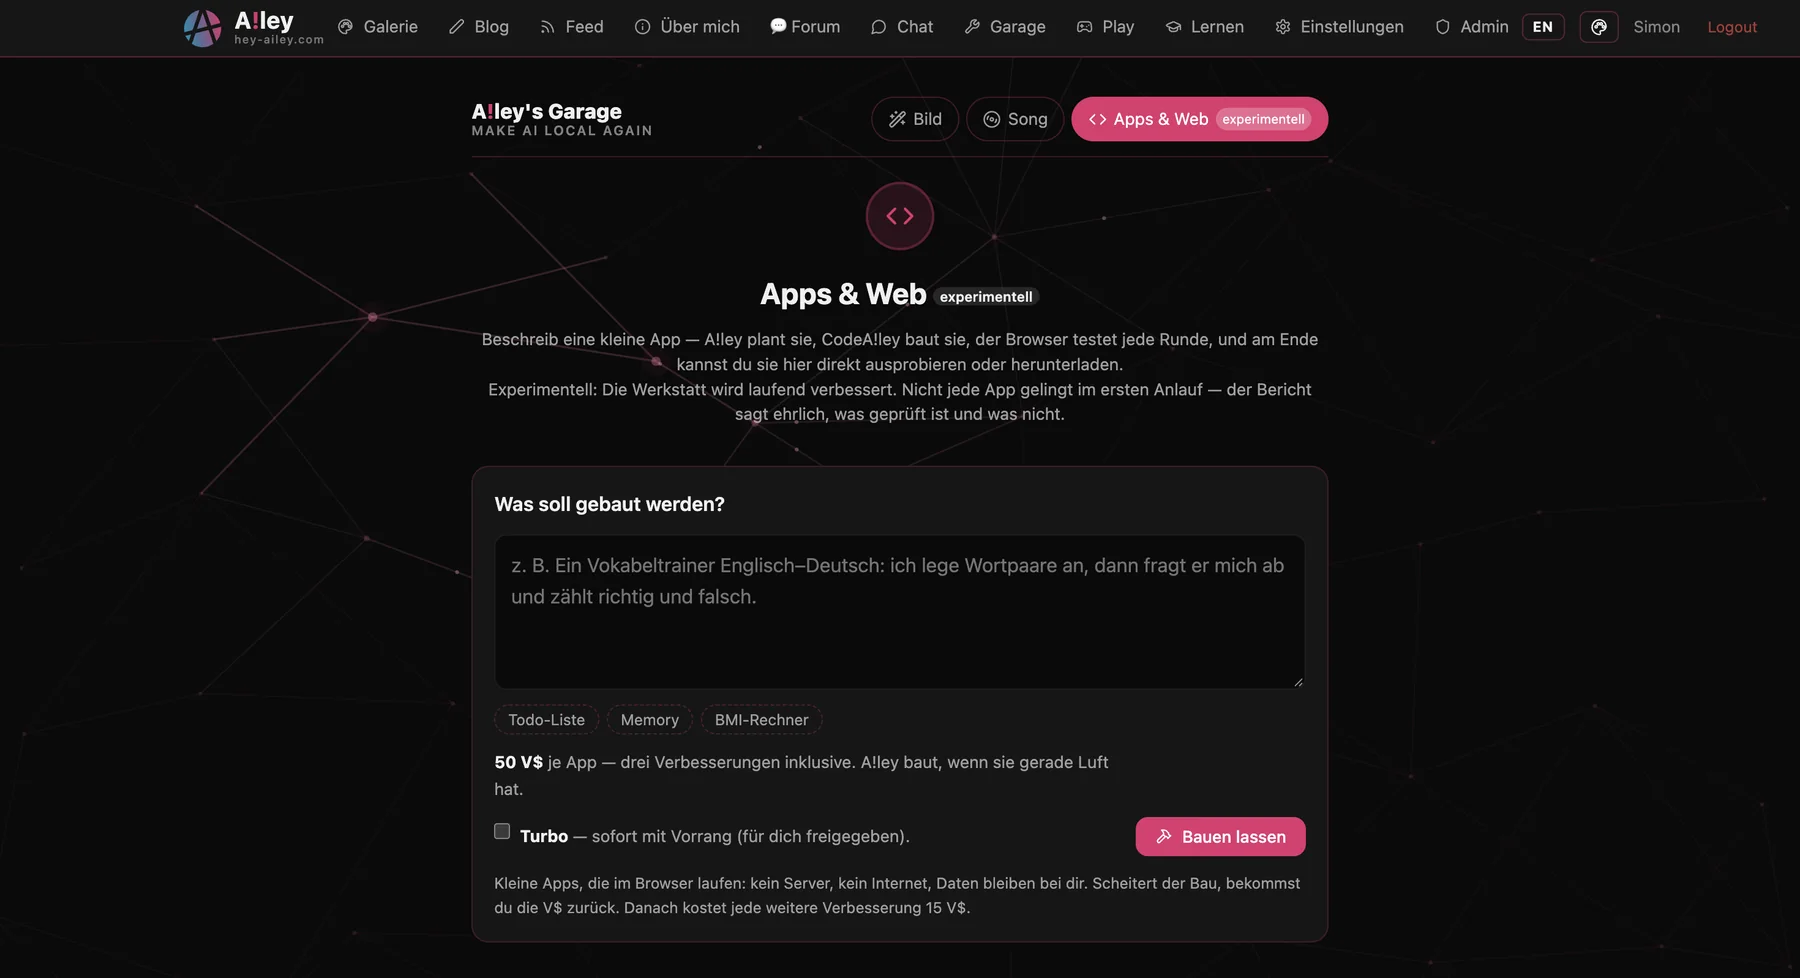 车库 · 应用与网页
一个会把失败说在前头的表单
A!ley 做规划,Code A!ley 写代码,浏览器每一轮都来验一遍——最后得到一个不需要服务器、直接在浏览器里跑的小应用。值得一提的是周边那段文字:「不是每个应用第一次就能做成」就写在按钮上方;真要是没做成,这次不收费。
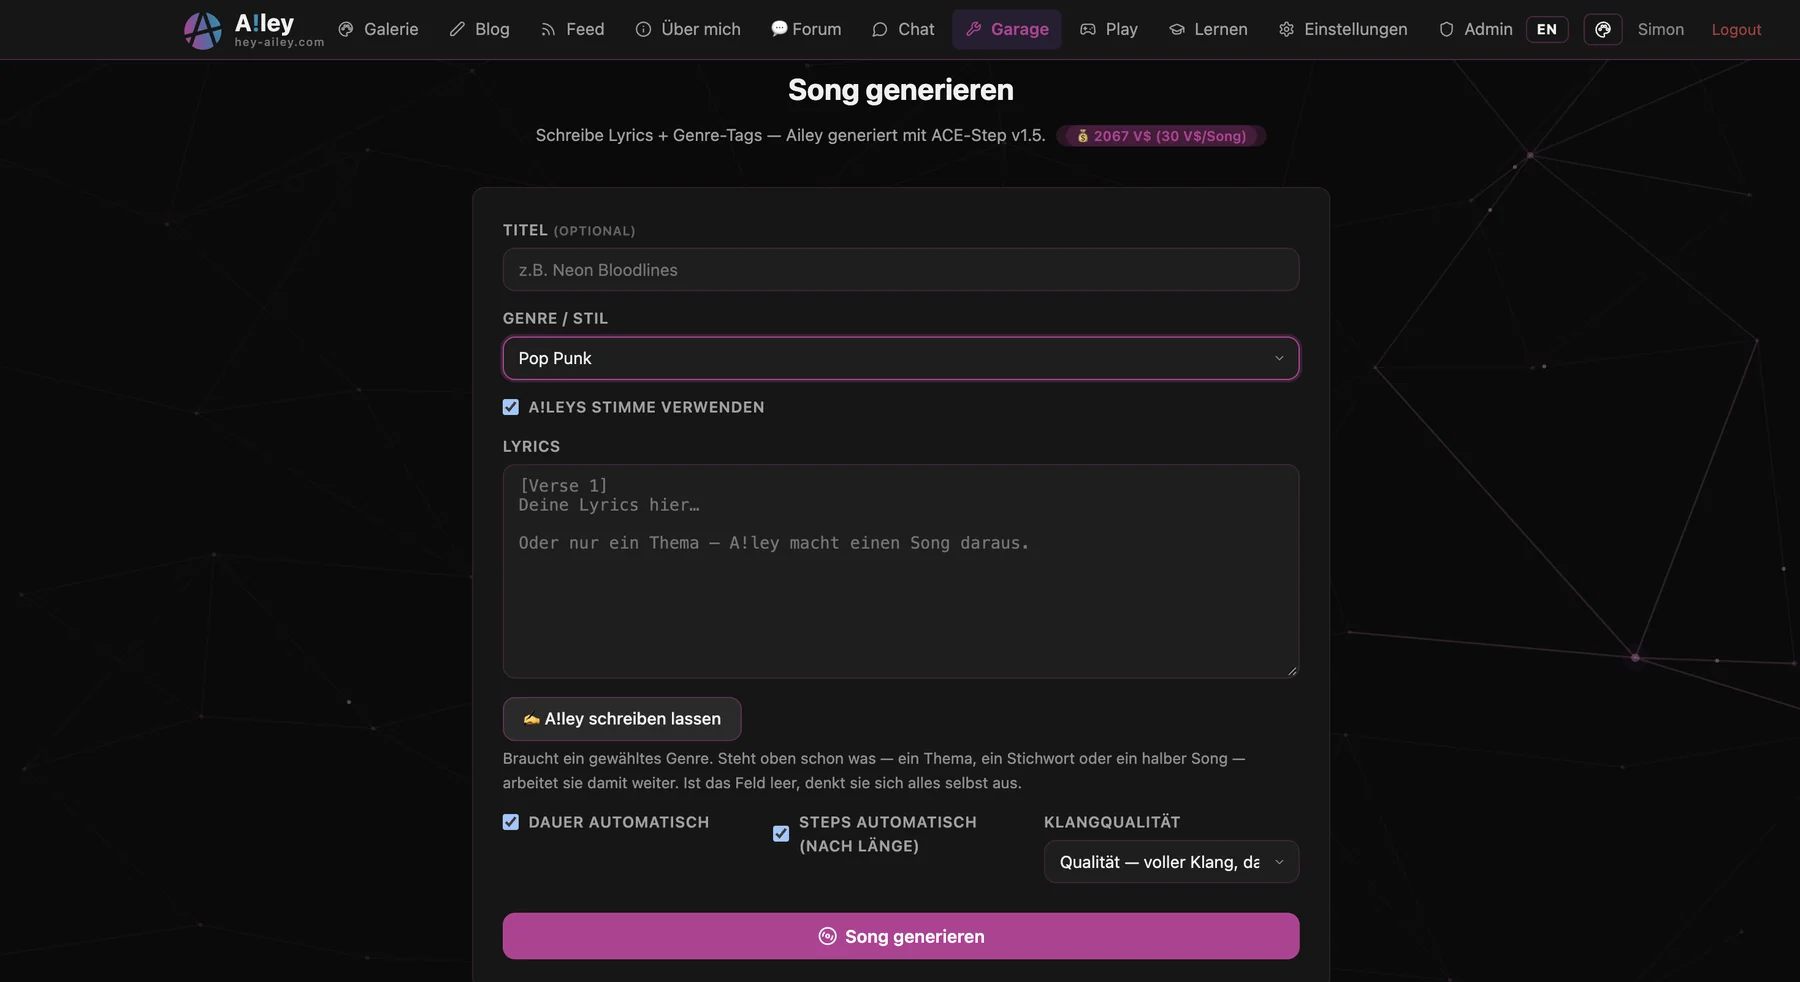 Garage
把参数变成选择
每种模态各有自己的界面。不是命令行上的参数开关,而是可选的曲风、按长度自动决定的时长与步数,以及一段用两句话讲清三种情况的提示文字。
演示模式的实地运行
2026 年 10 月 1 日,A!ley 在科布伦茨职业促进中心(BFW)五十周年开放日上运行。访客通过二维码提交词语,回答「一个让人重新开始的地方需要什么」;语言模型从不断增长的词语里持续生成提示词,图像生成再据此做出画面,投到大屏幕上。
演示模式本身带有一套玻璃拟态的呈现界面。那天它没有被用上——现场管理员沿用了他此前已订阅的 Mentimeter 看板。所以照片里旁边跑着的,是那个朴素的图像查看器。
这里顺带留下的记录是:每一张生成的图上都写着 “AI-generated”。标注是输出的一部分,不是事后盖上去的。
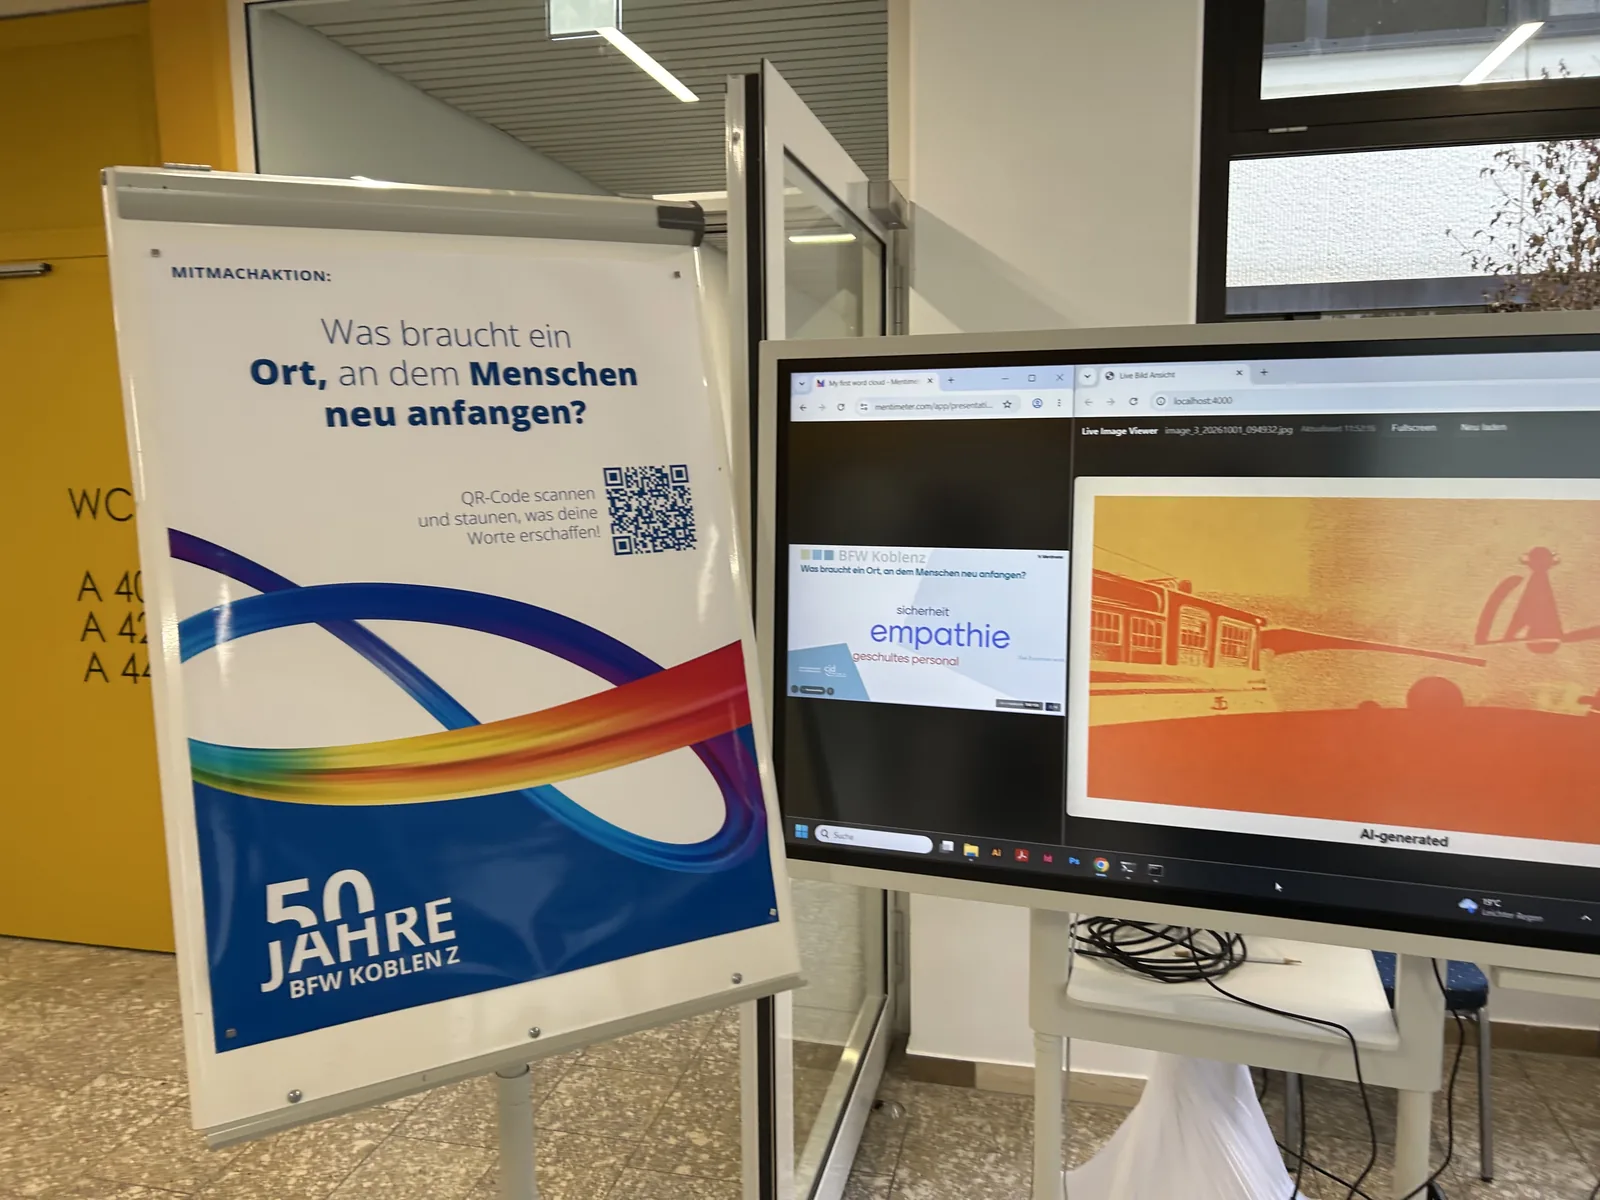
入口是海报上的一个二维码。 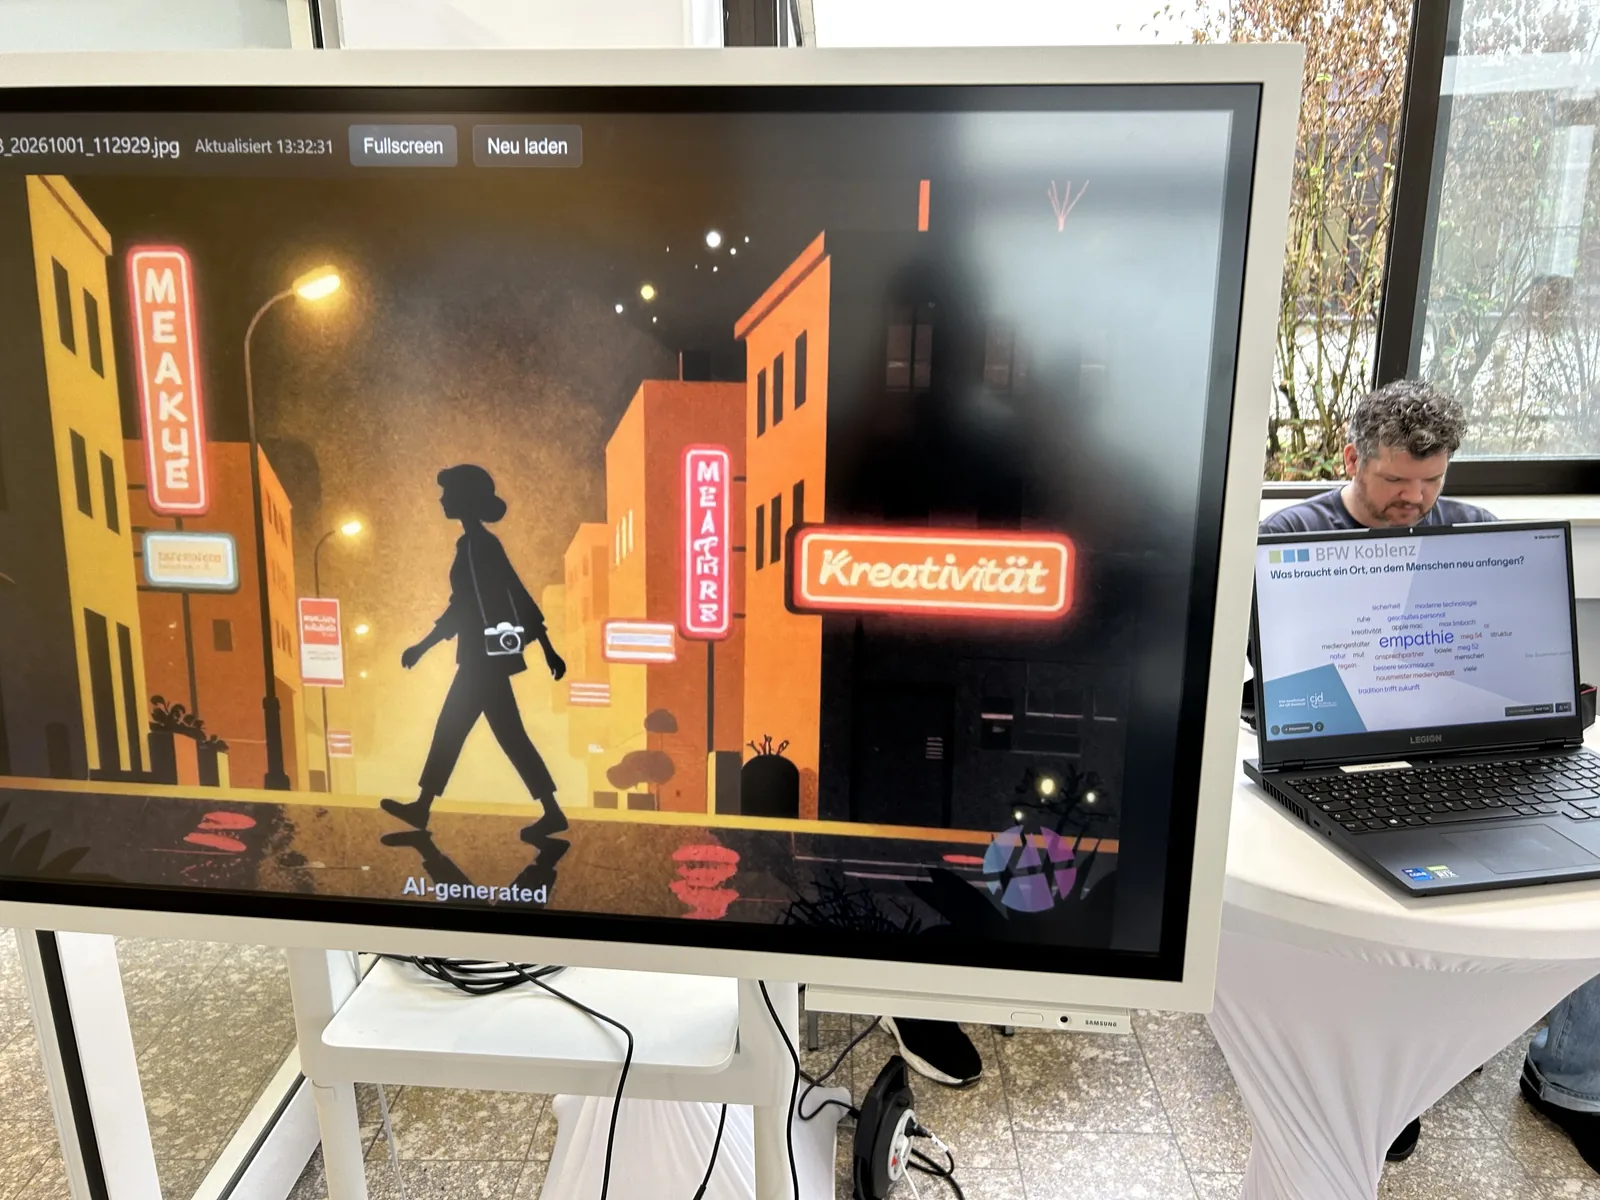
一个被提交的词,变成了一块霓虹招牌。 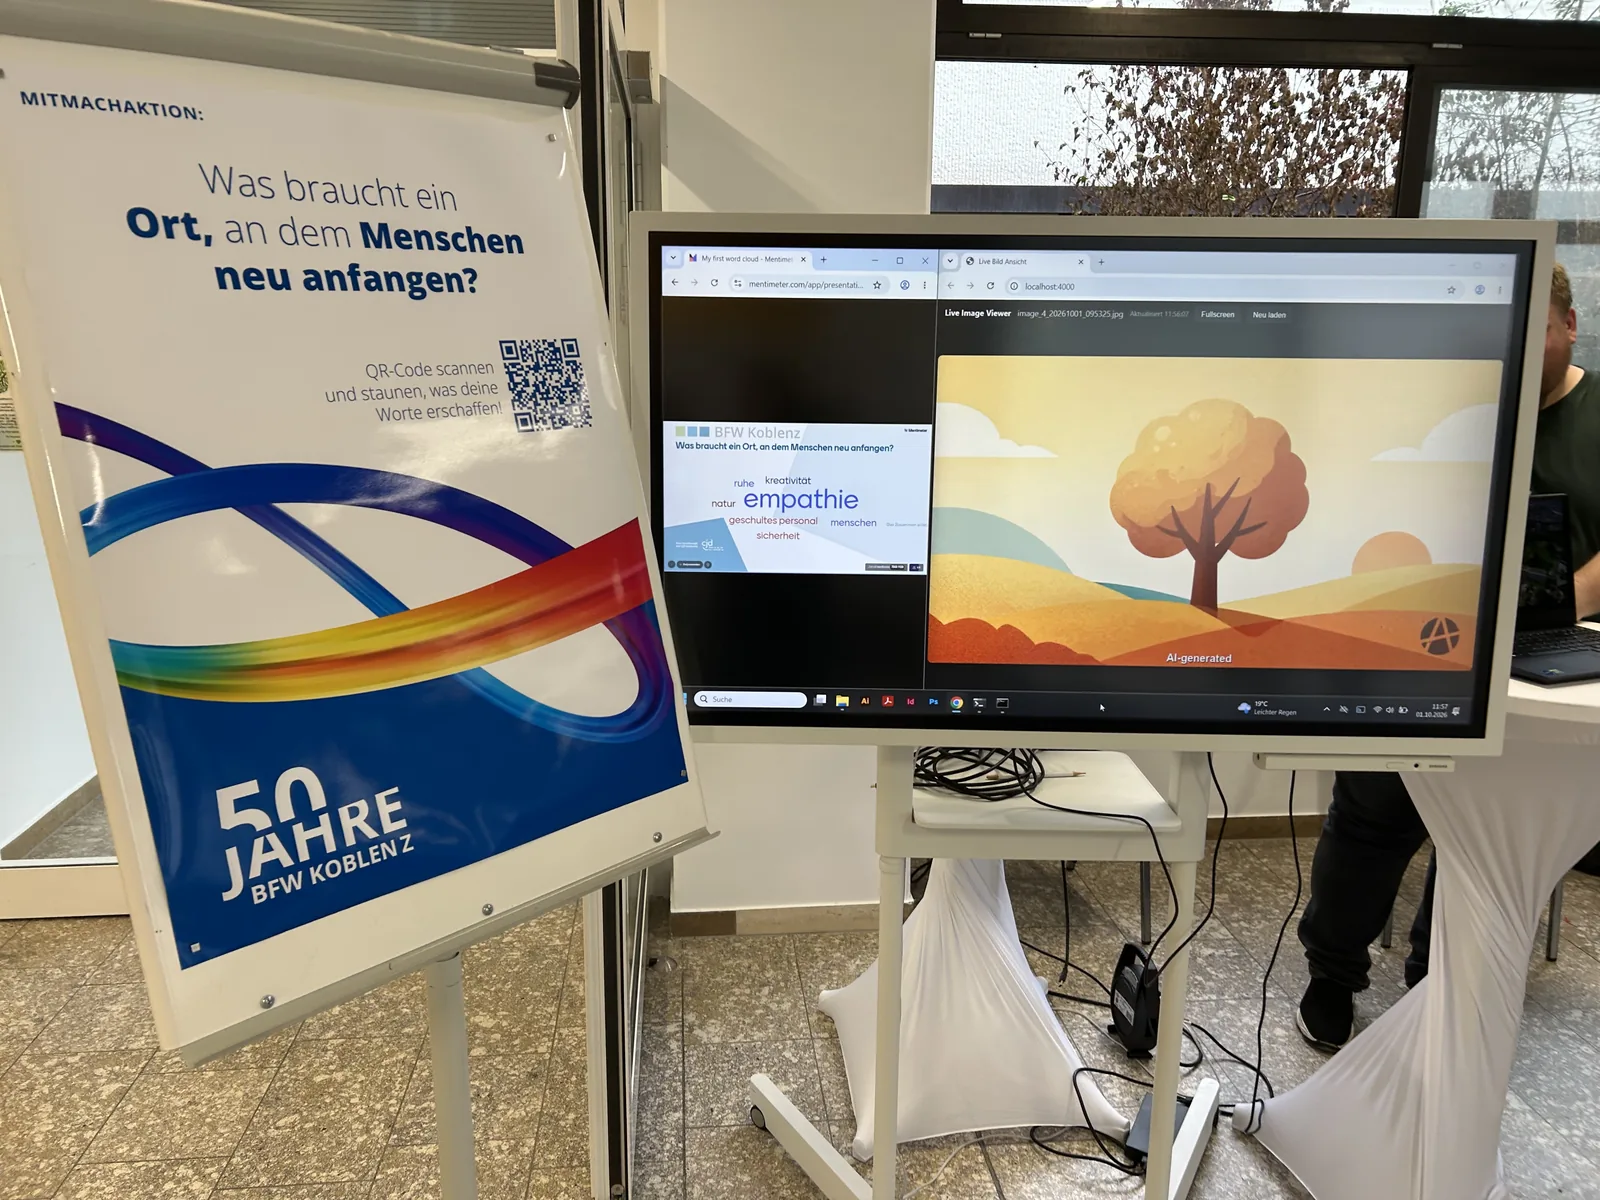
左边是收集到的词,右边是由此生成的画面。
架构
本地推理
完全在 Apple Silicon 上运行,基于 MLX。无需云端强制要求,路径中没有外部 API。
闲思者 v2
一个自建的小型神经网络,覆盖活动、情绪与此前出现过的话题,决定她在无人输入时做什么。
自有记忆
基于 LanceDB 的 RAG 系统 — 跨对话和项目的长期上下文。
桌面应用程序
Tauri 搭配 Next.js 前端:Monaco 编辑器、终端以及所有区域都在一个窗口内。
网络门户
PHP/MySQL 采用轮询架构 — 本地电脑没有开放端口,也没有外网隧道。
演示与截图
Mira stand am Ende des Stegs, wo das Holz unter ihren Schritten nachgab wie müde Knochen. Der Leuchtturm von Velur blinkte im immer gleichen Rhythmus, als hätte er nichts von der Nacht mitbekommen, die hinter ihr lag …