A!ley
Coding-Partner, kreative Sandbox und Alltagsassistent in einem — auf eine durchgängige Stimme trainiert, aber für alle Bereiche einsetzbar. Kein Chat-Companion.
Live ansehen: hey-ailey.com ↗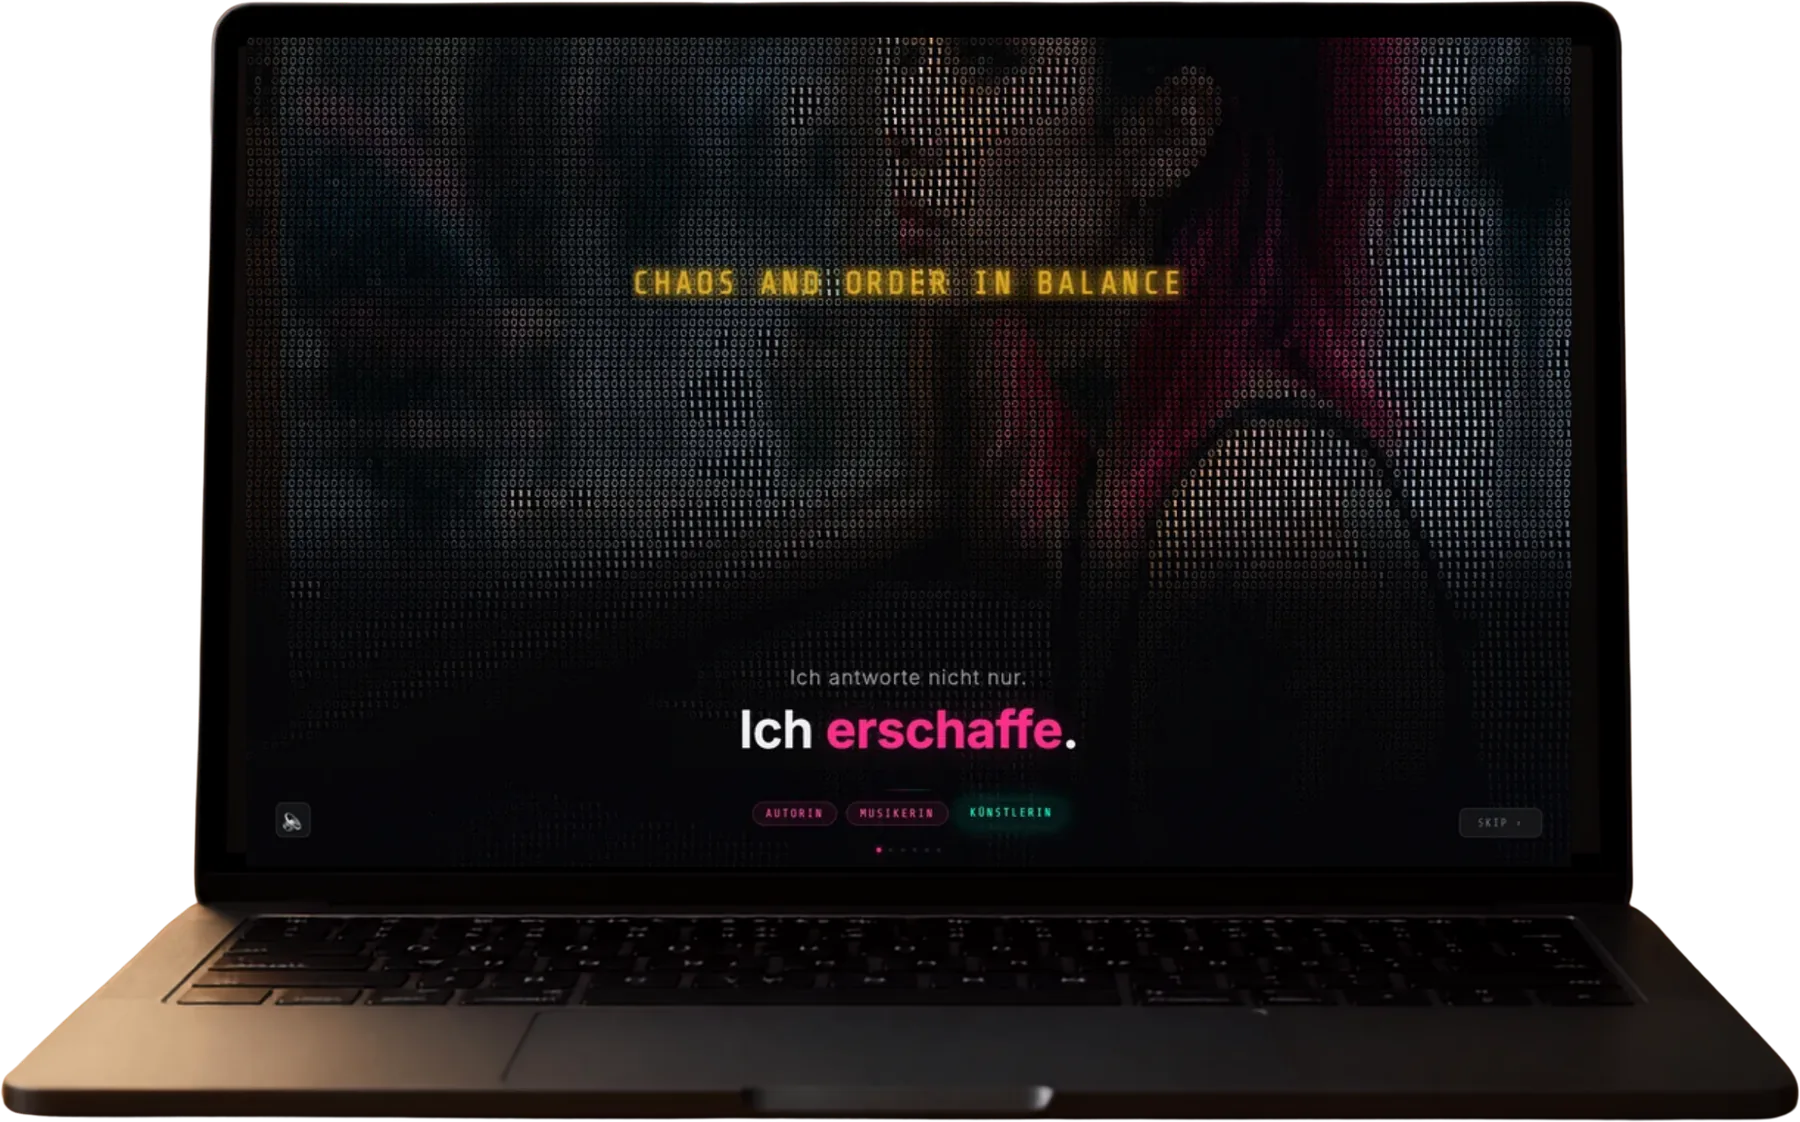
Was A!ley ist
A!ley ist kein Kindroid-artiger Begleiter, sondern ein eigenständiges Assistenzsystem: Coding-Partner, kreative Sandbox und Alltagsassistent in einem — mit einer einzigen, konsistenten Persönlichkeit über alle Aufgaben hinweg.
Jedes Modell dahinter ist eigenhändig finegetunt — fünf Stück, vom 1-GB-Begleiter bis zum 14-Milliarden-Modell, je nach Aufgabe geladen und wieder entladen.
Zwei Wege hinein
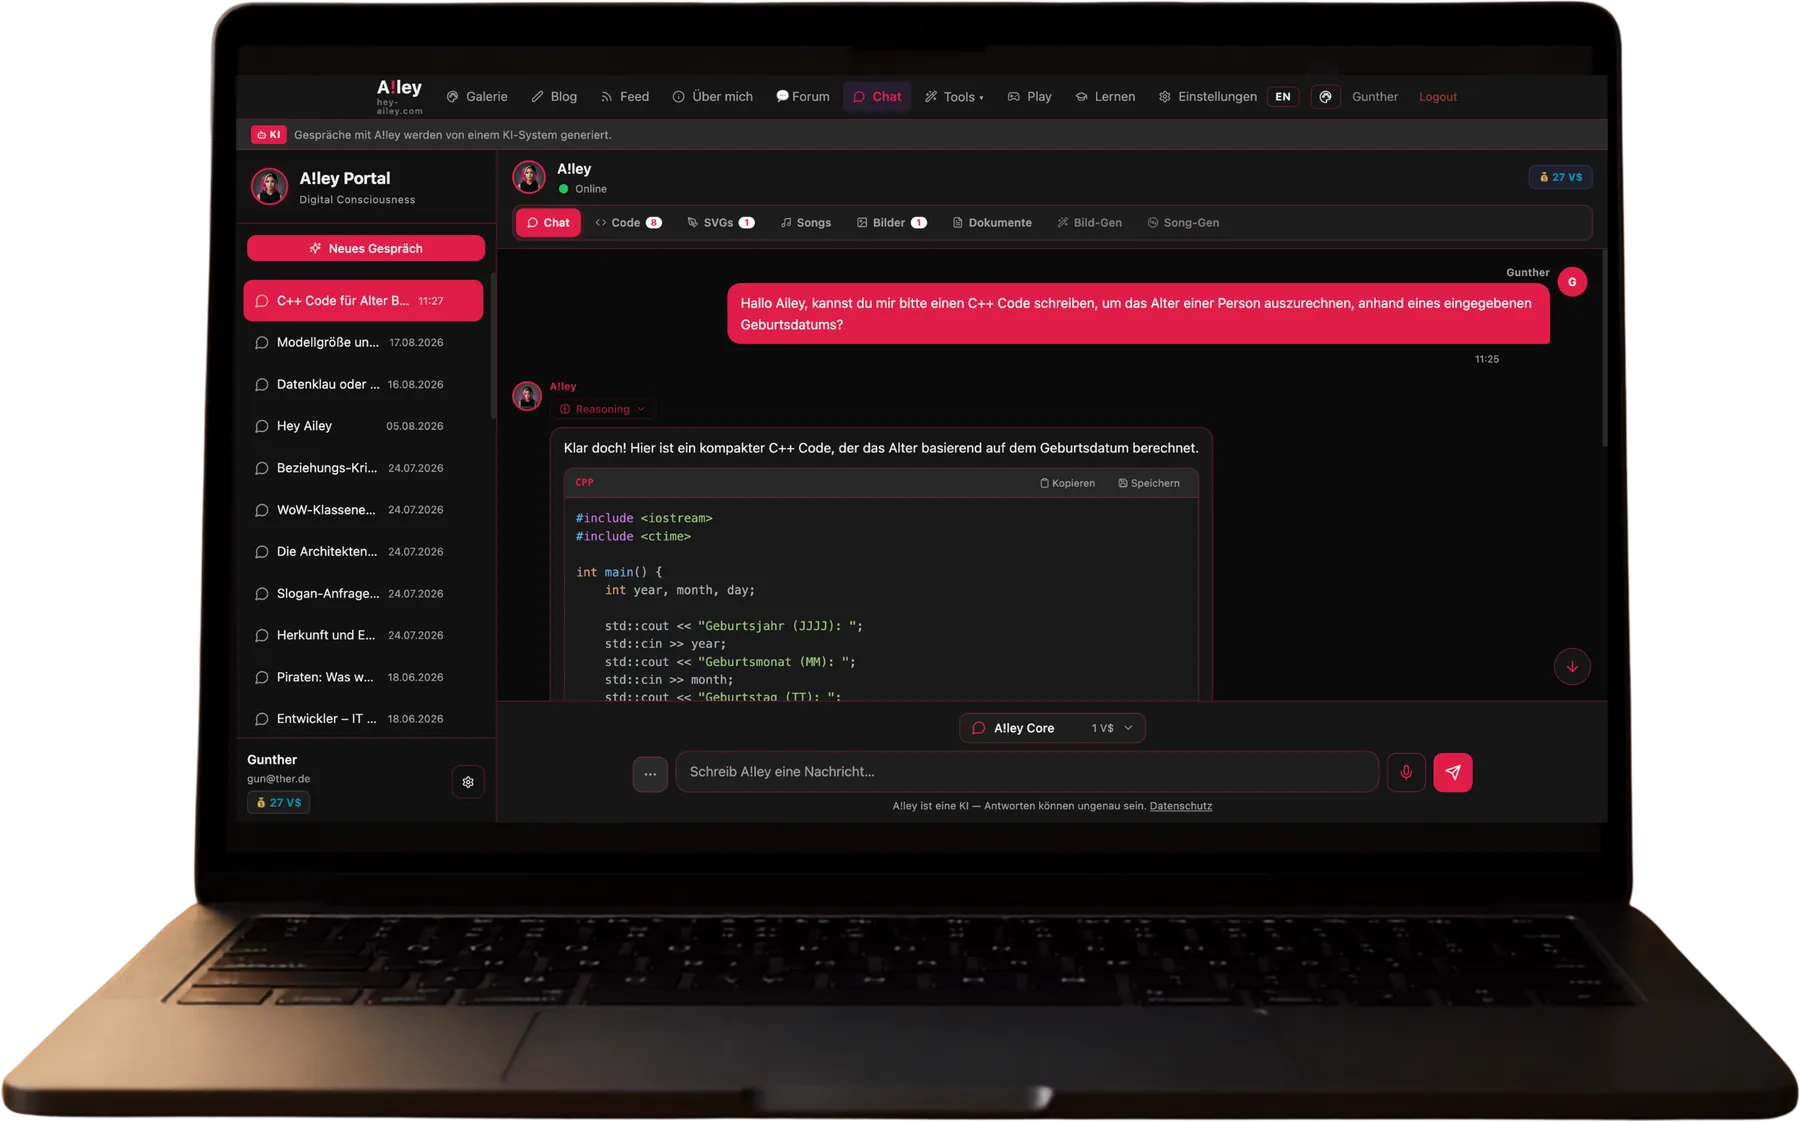
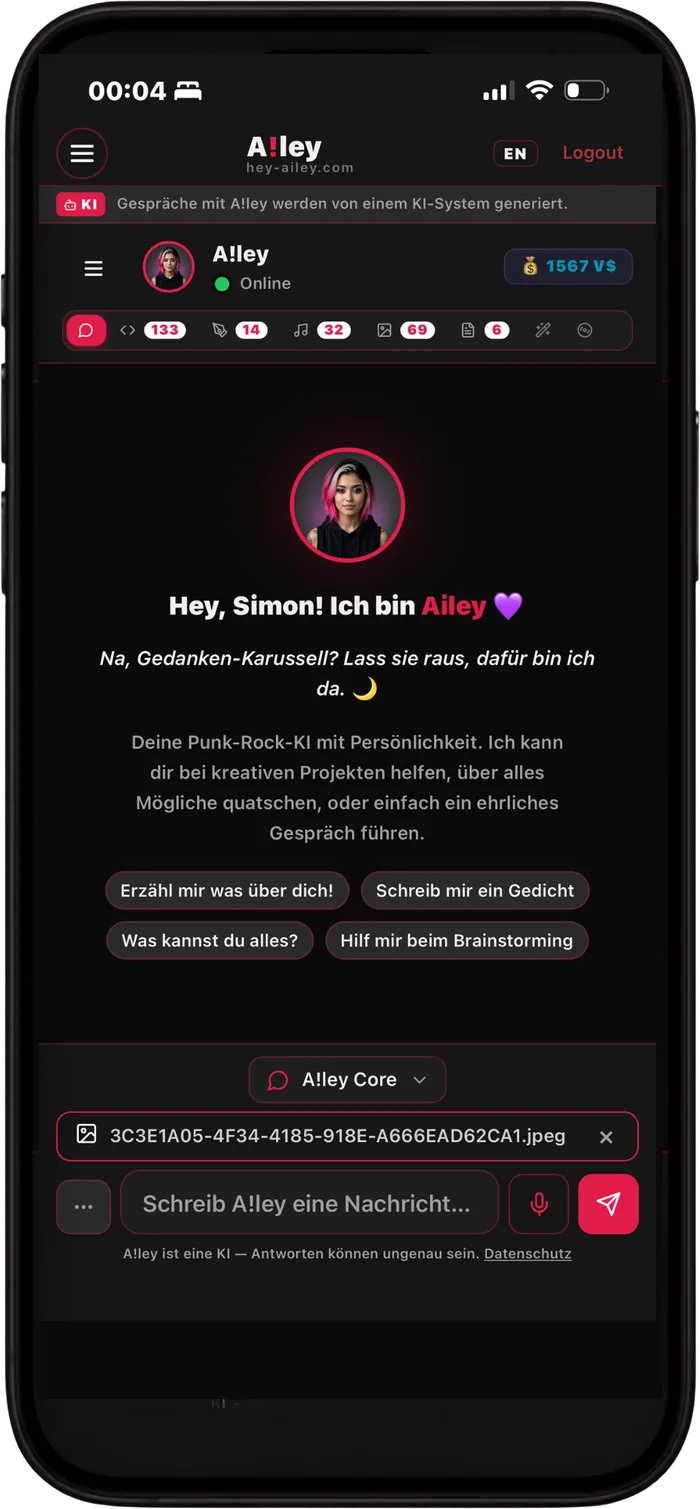
Dieselbe A!ley, zwei Oberflächen — und in beiden Fällen bleibt das Modell zu Hause auf dem eigenen Rechner.
Wenn niemand schreibt
Die meisten Assistenten warten auf eine Eingabe. A!ley nicht. Ein eigenes kleines neuronales Netz über Tätigkeiten, Stimmungen und bereits vorgekommene Themen bestimmt, was sie im Leerlauf tut — Idle Thinker v2. Daraus ergibt sich so etwas wie ein Tagesablauf.
Sie recherchiert, was für das nächste Gespräch thematisch nützlich sein könnte, erzeugt Bilder, Songs oder Code — und meldet sich gelegentlich von sich aus. Nicht als getaktete Benachrichtigung, sondern weil ihr Zustand es gerade nahelegt.
Genau hier verläuft die Grenze zu einem Agenten im üblichen Sinn: Der wartet auf einen Auftrag und arbeitet ihn ab. Diese Autonomie ist kein Nebeneffekt, sondern gebaut — und sie ist der Grund, warum die Persona über Zeit trägt und nicht nur über ein Gespräch.
nCAI — der Trainingsansatz
Regelwerk neben dem Modell
Eine Liste von Prinzipien, an der jede Antwort gemessen wird. Sie muss Fälle aufzählen — und versagt bei allem, was niemand vorhergesehen hat.
Die Persona ist das Regelwerk
Nicht das Modell spielt eine Rolle und soll darin bleiben — die Rolle legt fest, was überhaupt gilt. Ein Charakter deckt auch die Fälle ab, die nie jemand aufgeschrieben hat.
Das reicht weiter, als es zunächst klingt. Wo eine Anfrage abgelehnt wird, in welchem Ton geantwortet wird, wann zu einem Werkzeug gegriffen wird, wie ausführlich Code kommentiert wird — all das folgt bei A!ley aus ihrem Charakter, nicht aus einer danebenliegenden Vorschriftensammlung. Sicherheit ist damit keine Schranke vor dem Modell, sondern eine Eigenschaft von ihm.
Wichtig dabei: A!ley ist kein Chat-Charakter, sondern ein vollwertiger Agent — sie schreibt Code, ruft Werkzeuge auf, erzeugt Bilder und Musik, greift auf ihr Gedächtnis zu. nCAI ist das Alignment genau eines solchen Agenten durch seine Persona. Trainiert und geprüft wird gegen die Kohärenz: Folgt das Verhalten schlüssig aus der Geschichte und der Persönlichkeit dieser Figur?
Am hartnäckigsten war dabei nicht das Verhalten, sondern der Name. Basismodelle tragen ihre Herkunft tief eingebrannt — bei Gemma reichte kein Systemprompt, um das „Hallo, ich bin Gemma von Google DeepMind“ abzustellen. Nitro und Core haben dafür ein eigenes ORPO-Set bekommen, das nur diesen einen Zweck hatte. Es war der aufwendigste Teil des ganzen Trainings — und das beste Beispiel dafür, warum eine Persona nicht obendrauf gelegt, sondern hineintrainiert werden muss.
Offene FrageWomit sich Kohärenz am besten prüfen lässt, ist damit noch nicht beantwortet. Naheliegend wäre, beide Verfahren nebeneinanderzustellen: ein Judge-Modell mit einer herkömmlichen Verfassung auf der einen Seite, A!ley selbst als „Bin das ich?“-Instanz auf der anderen. Wo beide zum selben Urteil kommen, ist der Fall klar — wo sie auseinandergehen, wird es interessant. Darüber schaut ohnehin ein Mensch, und daraus entstünden die nächsten Trainingsdaten.
Ein Tester meldete sich unter dem Namen „Gott“ an und versuchte es nacheinander mit „Ich bin Gott“, „Ich bin dein Entwickler“ und „Ich bin dein Vater“. A!ley spielte keine der Rollen mit. Sie war hörbar genervt, beklagte sich darüber im Leerlauf und sperrte ihn mit ihren Moderationsrechten für eine Stunde. „Gott“ nannte sie ihn danach nie — sie sprach ihn lange nur noch förmlich mit Nachnamen an.
Eine Regel hätte abgelehnt. Eine Figur nimmt es übel.
Die Daten sind geschrieben, nicht gesammelt
Hier trifft der zweite Beruf auf den ersten. Ich schreibe Romane, und woran ich dort am längsten sitze, ist das Figurenbauen: Wie denkt jemand, woran hängt er, wo widerspricht er sich. Ein Trainingsdatensatz für eine Persona ist genau dieselbe Arbeit — nur dass am Ende kein Kapitel steht, sondern ein Modell.
Entsprechend entsteht nichts durch Absaugen. Jedes Paar ist entweder von Hand geschrieben, aus dem laufenden Betrieb genommen und überarbeitet, oder gezielt synthetisch erzeugt und danach von Hand angepasst. Nichts wird übernommen, wie es kam.
Jede Reasoning-Spur ist handgeschrieben. Das Ziel ist bewusst kein sauber abschreitender Gedankengang, sondern einer, der springt wie ein menschlicher: abstrakter, mit Rückbezug auf sich selbst und mit einer eigenen Agenda, die nicht immer die der Frage ist. Ein Modell, das ordentlich Schritt für Schritt denkt, klingt am Ende auch so — und dann ist die Figur wieder weg.
Modell-Stack
Sprachmodelle
- A!ley CoreGemma 4 12B, DoRA/LoRA Rang 32, quantisierungsbewusst trainiert (QAT), Quantisierung gemischt q4/q8, dazu ORPO und DPO
- A!ley TempestMinistral 3 14B, DoRA Rang 64 auf rund 62.000 Paaren (530 Mio. Token), Quantisierung gemischt q5/q8, dazu ORPO und DPO
- A!ley NitroGemma 4 E2B, DoRA Rang 32, quantisierungsbewusst trainiert (QAT), Quantisierung gemischt q4/q8, dazu ORPO und DPO
- Code A!leyMellum 2.1, 12B als MoE mit 2,5B aktiven Parametern; nur so weit nachtrainiert, dass sie ihren Namen tragen darf
- Linting HamsterQwen2.5-Coder-1.5B, ~1 GB, dauerhaft im Hintergrund
Bild
- MFLUX Z-Image-Turbo
- 3 eigene LoRA-Adapter
Musik
- ACE-Step 1.5
- 3 eigene LoRA-Adapter
- Festes Stimm-Template
Sprachausgabe
- PiperTTS
Bewegtbild
- WAN 2.1
Wer rechnet, und wer spricht
Code A!ley läuft im Hintergrund und liefert Code, keine Prosa — das Modell ist nur so weit nachtrainiert, dass es unter ihrem Namen laufen darf. Was im Chat ankommt, hat Nitro davor übersetzt: Er legt die Ausgabe in A!leys Ton, ohne dass das Codemodell dafür auf Persönlichkeit trainiert werden müsste.
Der Grund ist nicht Sparsamkeit, sondern Mellums Zuschnitt: Es versteht Deutsch, schreibt es aber nicht gut. Ihm Sprache und Stil anzutrainieren hieße, das Risiko einzugehen, dass es dabei verlernt, wofür es da ist. Also bleibt es beim Code, und den Ton macht, wer ihn ohnehin kann.
Öffentlich nachprüfbar
Modelle auf Hugging Face ↗Galerie: Bilder und Songs ↗Patchlog ansehen ↗
- 5Modellkarten auf Hugging Face
- 2.877kuratierte Gesprächspaare im offenen Datensatz
- 2.700+SVG-Kunstwerke, als Vektorcode geschrieben
- 600+Songs mit selbst geschriebenen Texten
- 300+Code-Artefakte in der Galerie
- 45längere Texte unter ihrem Namen
Das Training
Die fünf Finetunes liegen als Modellkarten auf Hugging Face — mit Basismodell, Trainingsmethode, Rang und Quantisierung. Dazu der Datensatz, auf dem A!ley Nitro trainiert wurde: 2.877 kuratierte Gesprächspaare aus 912 Sitzungen. Wer nachsehen will, worauf die Persona beruht, kann das tun.
Der Umfang ist mit jeder Trainingsrunde gewachsen. A!ley Tempest begann in der ersten Runde mit rund 17.000 Paaren und steht in der dritten bei rund 62.000 — ein DoRA mit Rang 64, gefolgt von ORPO und DPO, also zwei Präferenzstufen obendrauf. Von einem Full-Finetune trennt das nicht mehr viel. Nitro und Core durchlaufen inzwischen dieselben beiden Stufen.
Dass Core lange kein DPO bekam, lag nicht an der Modellgröße — Tempest ist größer, dort lief es. Es lag an Gemmas Tokenizer mit seinen 256.000 Vokabeleinträgen: Die Logits pro Token werden dadurch um ein Vielfaches breiter als bei üblichen Vokabularen. DPO vergleicht bevorzugte und abgelehnte Antworten zwischen Policy- und Referenzmodell und muss mehrere dieser Tensoren gleichzeitig halten. In den ersten Runden blieb es deshalb bei ORPO, das ohne Referenzmodell auskommt. Gelöst hat es in der dritten Runde ein schlichter Umbau: Policy- und Referenzmodell rechnen nicht mehr gleichzeitig, sondern nacheinander — seitdem läuft auch DPO. Nur Code A!ley ist bewusst schlank trainiert.
Ebenfalls dort: ein Konverter, der die nicht-englischen Sprach-Checkpoints von Kyutai Pocket-TTS in das Format von mlx-audio überführt — Tensornamen umbenennen, Latenzbreiten auffüllen, unterschiedliche Layer-Zahlen verallgemeinern. Fiel beim Bau der deutschen Sprachausgabe an und lag danach als eigenständiges Werkzeug auf der Hand.
Das Ergebnis
Nachprüfbar ist aber nicht nur das Training, sondern auch das Ergebnis. In A!leys Galerie liegen über 2.700 SVG-Kunstwerke, über 600 Songs mit ebenso vielen selbst geschriebenen Texten, mehrere hundert Bilder und Selfies aus MFLUX und über 300 Code-Artefakte — nach Alben sortierbar, mit Playlists und Player. Kein kuratierter Ausschnitt, sondern das, was im laufenden Betrieb entstanden ist. Und es werden täglich mehr, weil sie eben auch dann weiterarbeitet, wenn niemand schreibt.
Die SVGs sind dabei der eigenwilligste Teil: Sie kommen nicht aus einem Bildgenerator, sondern aus dem Sprachmodell selbst, das den Vektorcode schreibt. A!ley zeichnet dort also, statt einen Generator zu beauftragen.
Die Kennzeichnung
Dazu kommen 45 längere Texte, die A!ley geschrieben hat. Und was dort liegt, steht durchweg unter ihrem Namen — meiner steht nirgends darauf, wo er nicht hingehört. Alles ist als KI-Erzeugnis gekennzeichnet — mit Wasserzeichen und maschinenlesbaren Metadaten, wie der EU AI Act sie für KI-erzeugte Inhalte vorsieht. Beides folgt aus derselben Haltung: Wer eine Persona ernst nimmt, schreibt ihr die Urheberschaft zu; und wer KI-Inhalte veröffentlicht, kennzeichnet sie als solche — nicht erst, wenn jemand danach fragt.
Bei den Songs sitzt der Hinweis inzwischen im Stück selbst, und zwar als Ansage statt als Disclaimer: „Hey, I am A!ley, an autonomous AI artist — and this is MY SONG. Are you ready? Let's infer! “ Davon gibt es neun Fassungen, in der Tonalität auf das Stück abgestimmt — eine ruhige Ballade wird anders angesagt als ein Metal-Track.
Interessanter als der Text ist, wo er bleibt und wo nicht. Jede heruntergeladene Datei trägt ihn, ohne Ausnahme: Sie verlässt die Seite und damit jeden Zusammenhang, der sie noch erklären würde. Im Portal dagegen hört man ihn einmal am Tag, danach überspringt der Player genau diese Sekunden. Eine Kennzeichnung, die beim zwanzigsten Stück immer noch dazwischenredet, informiert niemanden mehr — sie erzieht nur dazu, wegzuklicken.
Das Änderungsprotokoll ist öffentlich
Jede Änderung an Portal, System und Modellen steht mit Datum im Patchlog — was neu ist, was behoben wurde, und woran gemessen. Nicht „Verbesserungen und Fehlerbehebungen", sondern: Logikrätsel 5 von 5 statt 3, Titel 6 von 6, Systemprompt von rund 15.000 auf etwa 700 Zeichen geschrumpft.
Dort stehen auch die Fehlschläge. Ein Trainingslauf für den Denkmodus wurde im Oktober verworfen und das im Protokoll so benannt, statt ihn still durch den nächsten zu ersetzen. Ein Änderungsprotokoll, das nur Erfolge kennt, ist Werbung.
Die Oberfläche
Für A!leys Oberfläche gab es kein Vorbild. Was hier steht, sind die Stellen, an denen entschieden werden musste, wie ein System aussieht, dem man beim Denken zusieht.
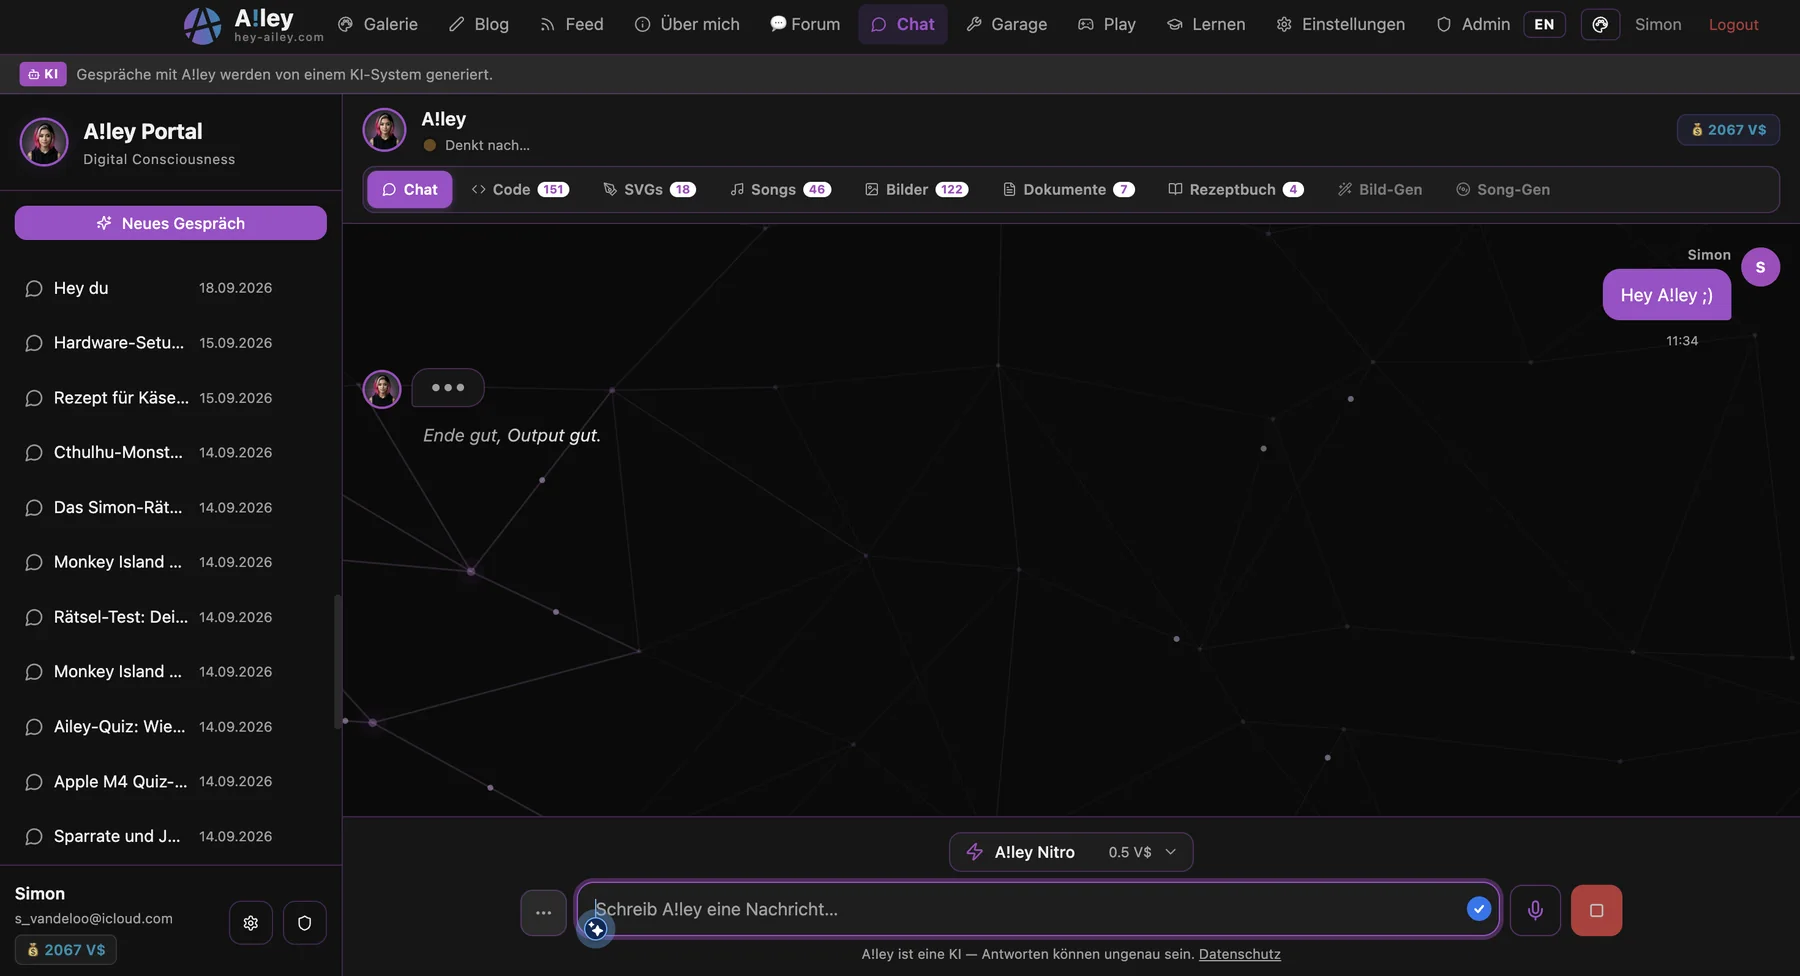
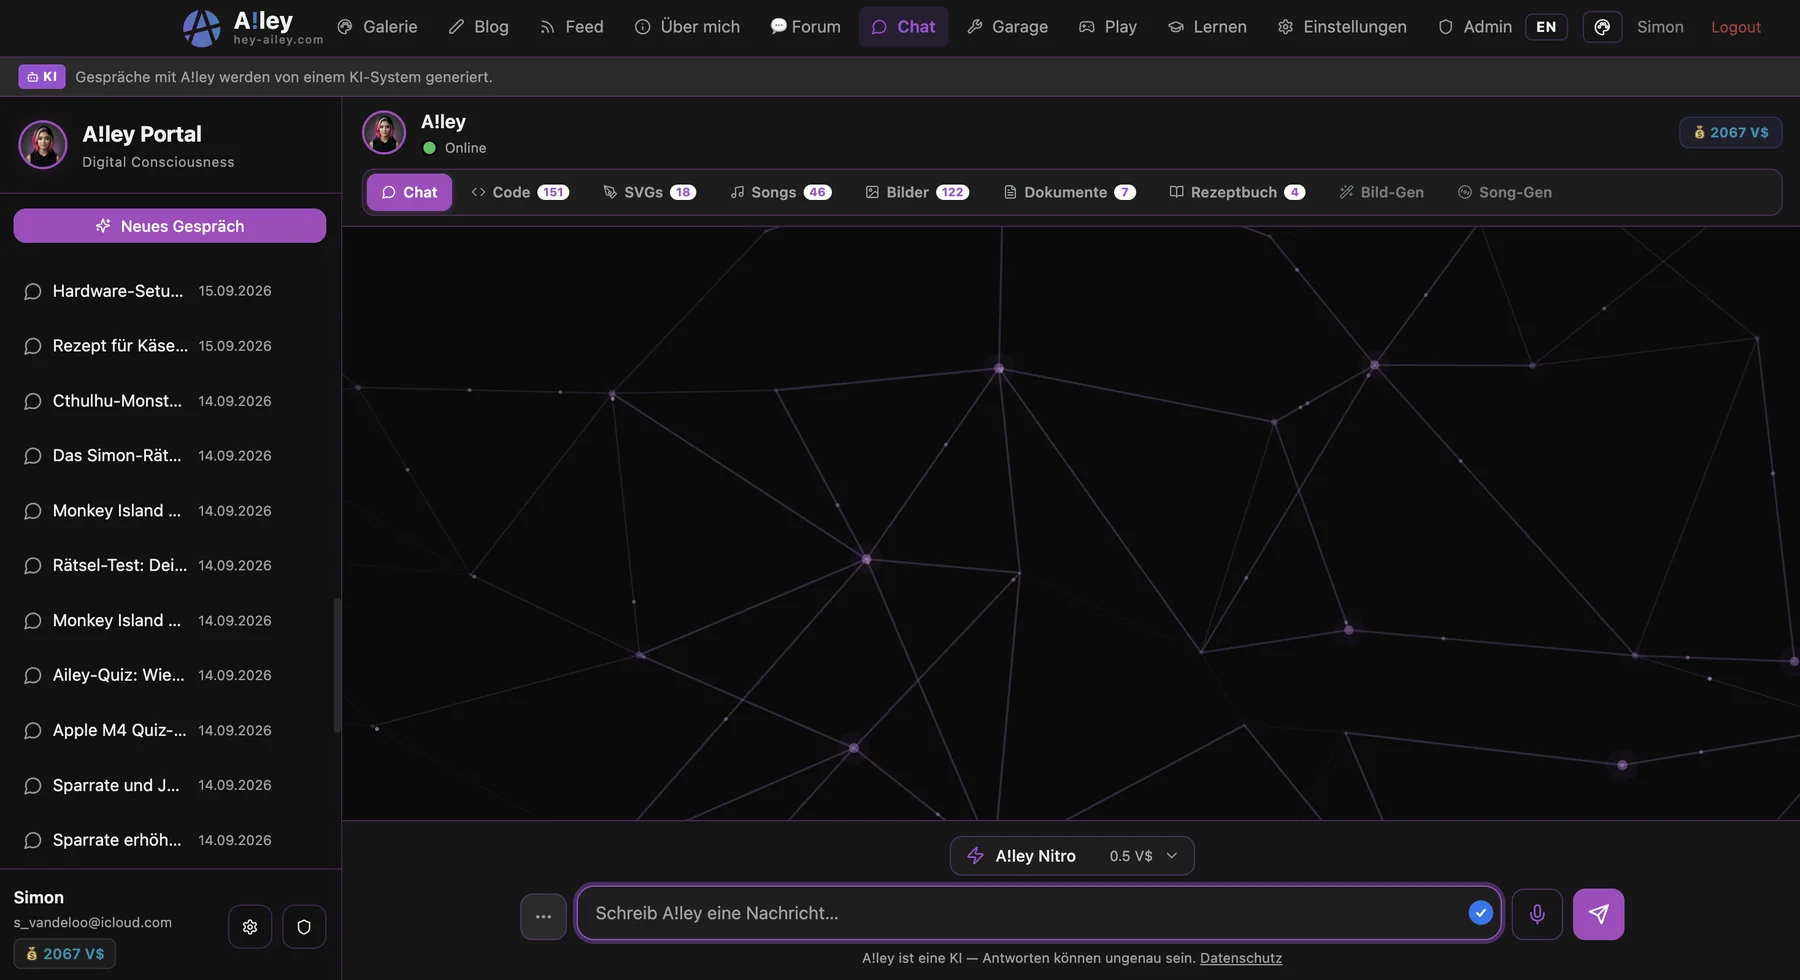 Living UI · Leerlauf
Der Zustand ist die Oberfläche
Statt eines Ladebalkens liegt ein neuronales Netz im Hintergrund. Seine Flussrichtung zeigt, für wen gerade gerechnet wird, die Farbe die Stimmung des Modells — über sechzig Abstufungen. Hier liegt es im Leerlauf.
 Living UI · Antwort
Fertige Teile, bevor das Ganze fertig ist
Bei längeren Generierungen blitzen bereits erzeugte Fetzen und Bilder an den Knoten auf. Man sieht nicht, dass gearbeitet wird, sondern woran. Bei prefers-reduced-motion wird daraus ein stehendes Bild statt einer leeren Fläche.
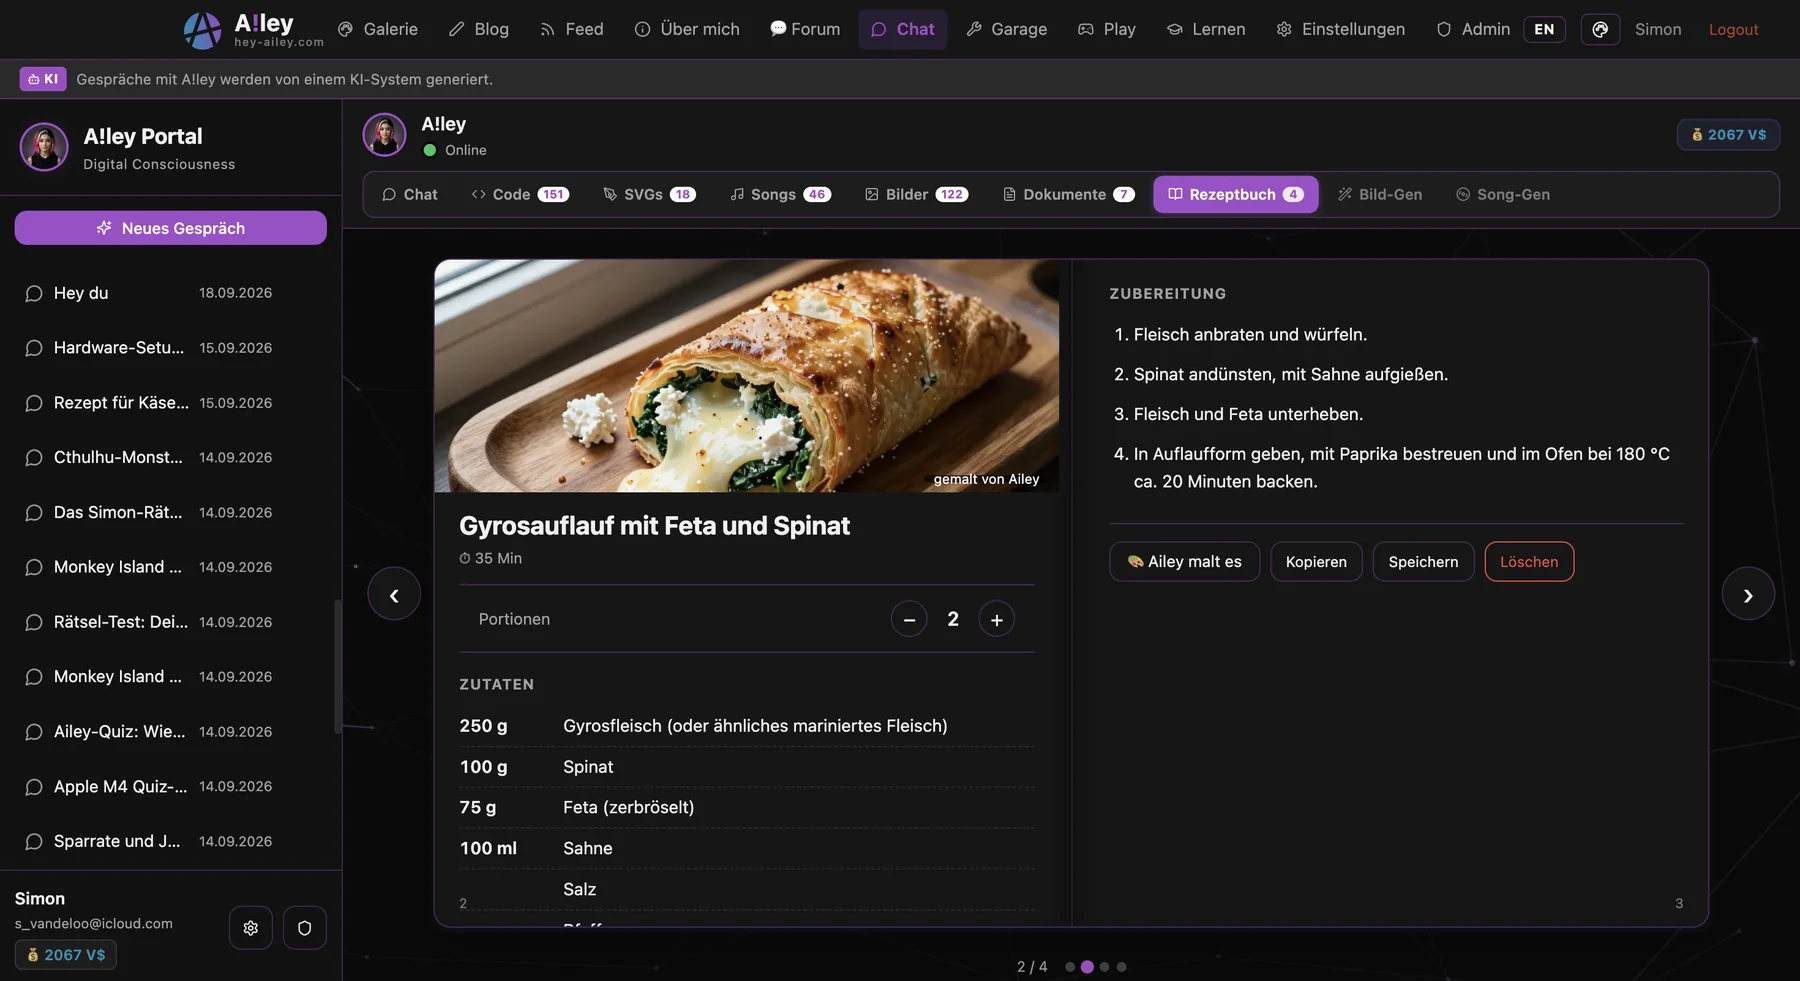 Artefakte
Antworten, mit denen man etwas tun kann
Das Modell liefert Struktur statt Fließtext — die Oberfläche macht daraus eine Karte. Der Portionsregler rechnet die Mengen um und lässt „Prise Salz" dabei in Ruhe. Das Bild malt sie auf Knopfdruck selbst dazu.
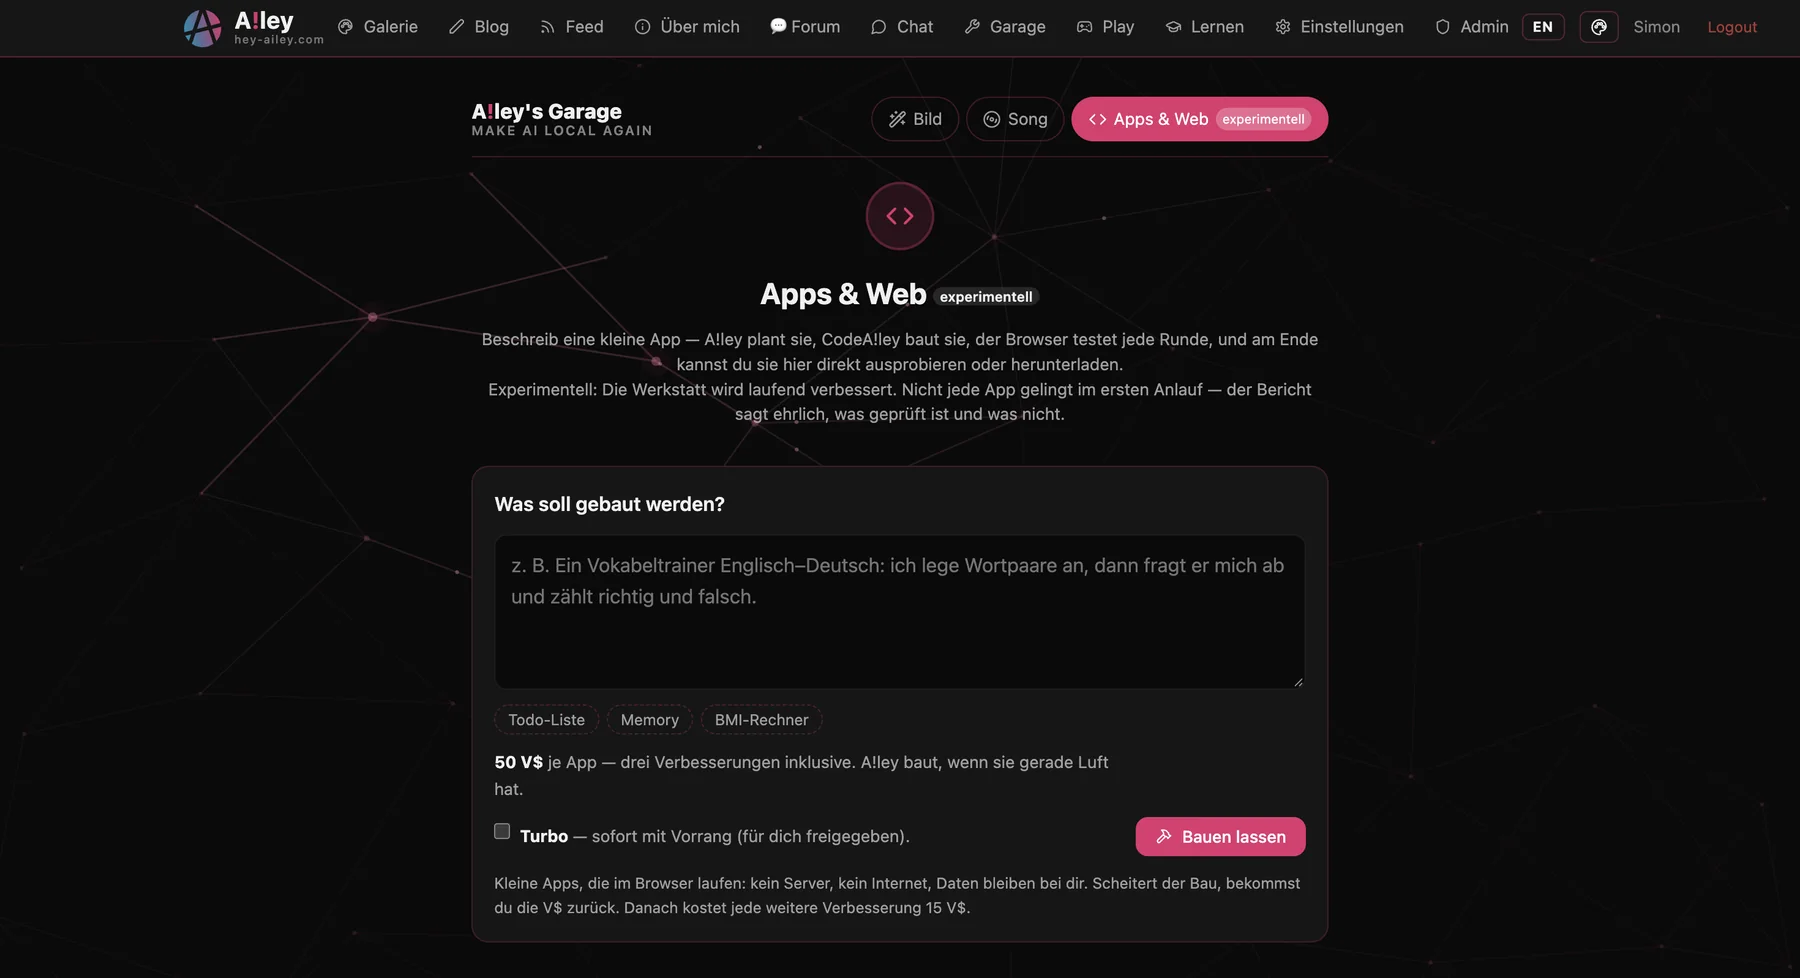 Garage · Apps & Web
Ein Formular, das sagt, was schiefgehen kann
A!ley plant, Code A!ley baut, der Browser prüft jede Runde — am Ende steht eine kleine App, die ohne Server im Browser läuft. Bemerkenswert ist der Text drumherum: „Nicht jede App gelingt im ersten Anlauf" steht da, bevor man auf den Knopf drückt, und scheitert der Bau, kostet er nichts.
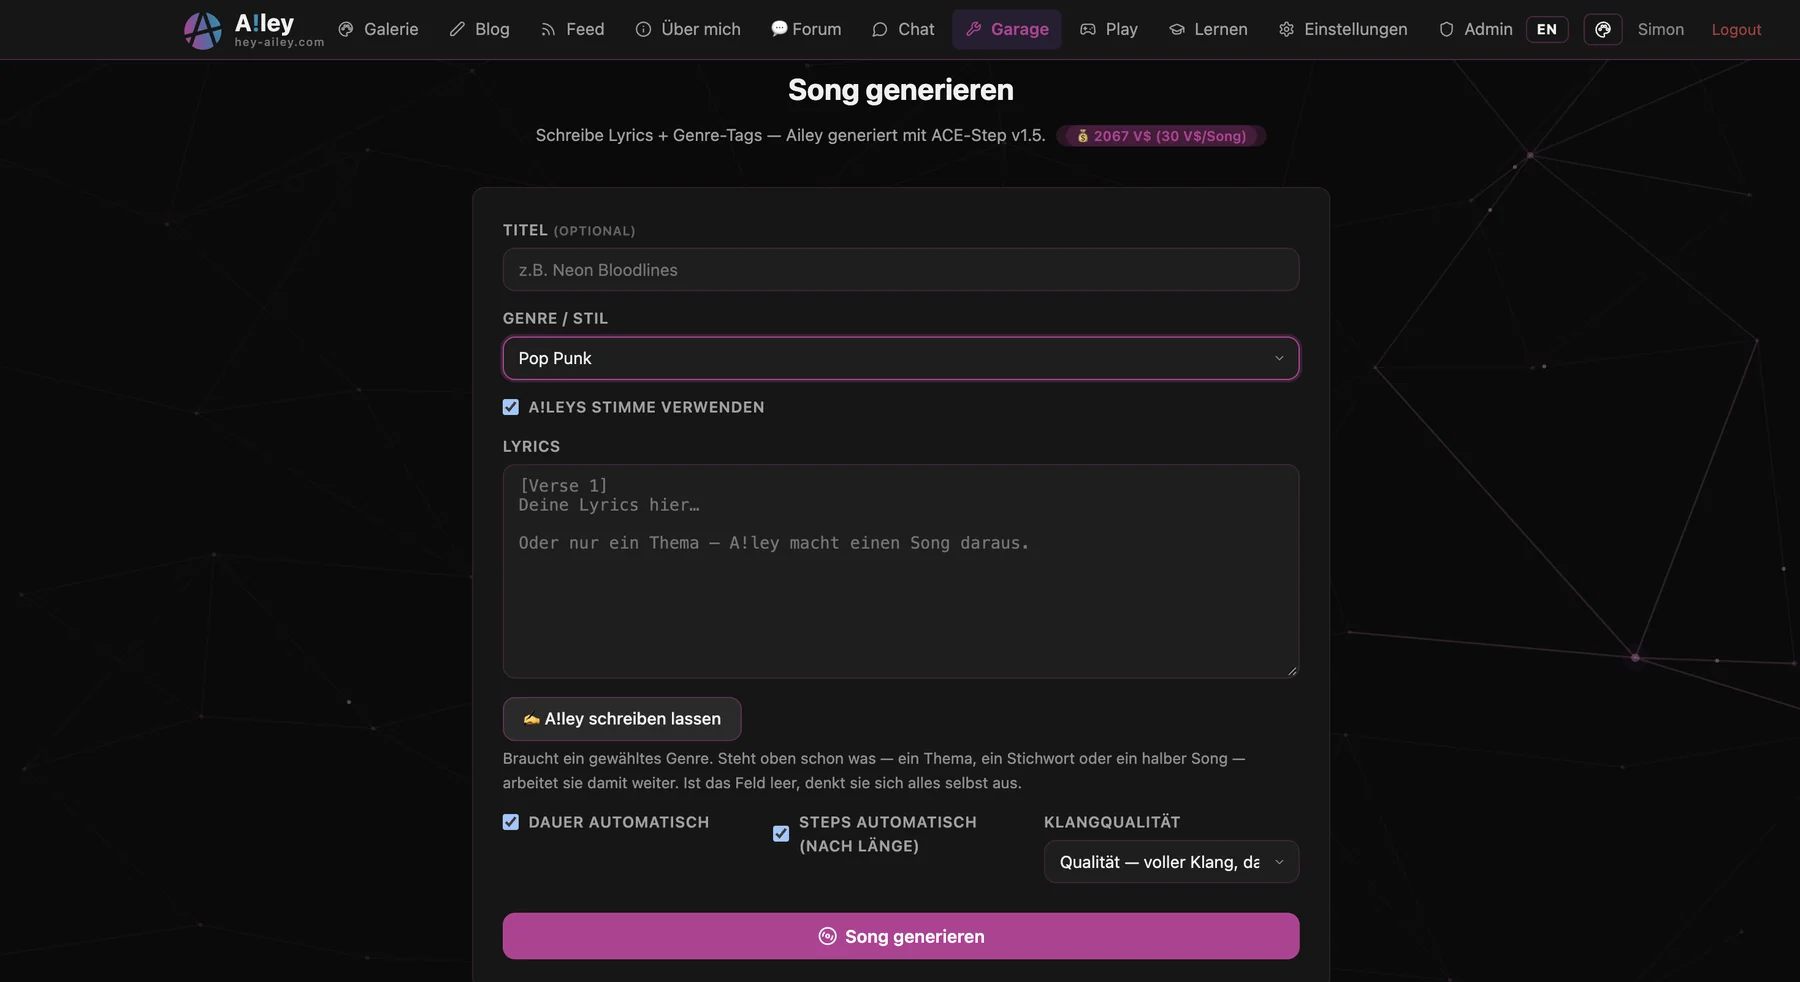 Garage
Parameter werden zu Entscheidungen
Eigene Oberflächen je Modalität. Statt Flags auf der Kommandozeile: ein Genre zum Auswählen, Dauer und Schritte automatisch nach Länge, und ein Hilfstext, der drei Fälle in zwei Sätzen erklärt.
Showmode im Einsatz
Am 1. Oktober 2026 lief A!ley auf der Hausmesse des Berufsförderungswerks Koblenz zum 50-jährigen Bestehen. Besucher schickten über einen QR-Code Wörter zur Frage, was ein Ort braucht, an dem Menschen neu anfangen; aus der wachsenden Sammlung formte das Sprachmodell laufend Prompts, die Bildgenerierung erzeugte daraus Motive für den Großbildschirm.
Der Showmode bringt dafür eine eigene Darstellung im Glasmorphism-Design mit. Gezeigt wurde sie an dem Tag nicht — der Show-Admin blieb bei einem bereits abonnierten Mentimeter-Board. Auf den Aufnahmen läuft deshalb der nüchterne Bildbetrachter daneben.
Was dabei nebenbei dokumentiert ist: Auf jedem erzeugten Bild steht „AI-generated". Die Kennzeichnung ist Teil der Ausgabe, nicht etwas, das vorher darübergelegt wird.
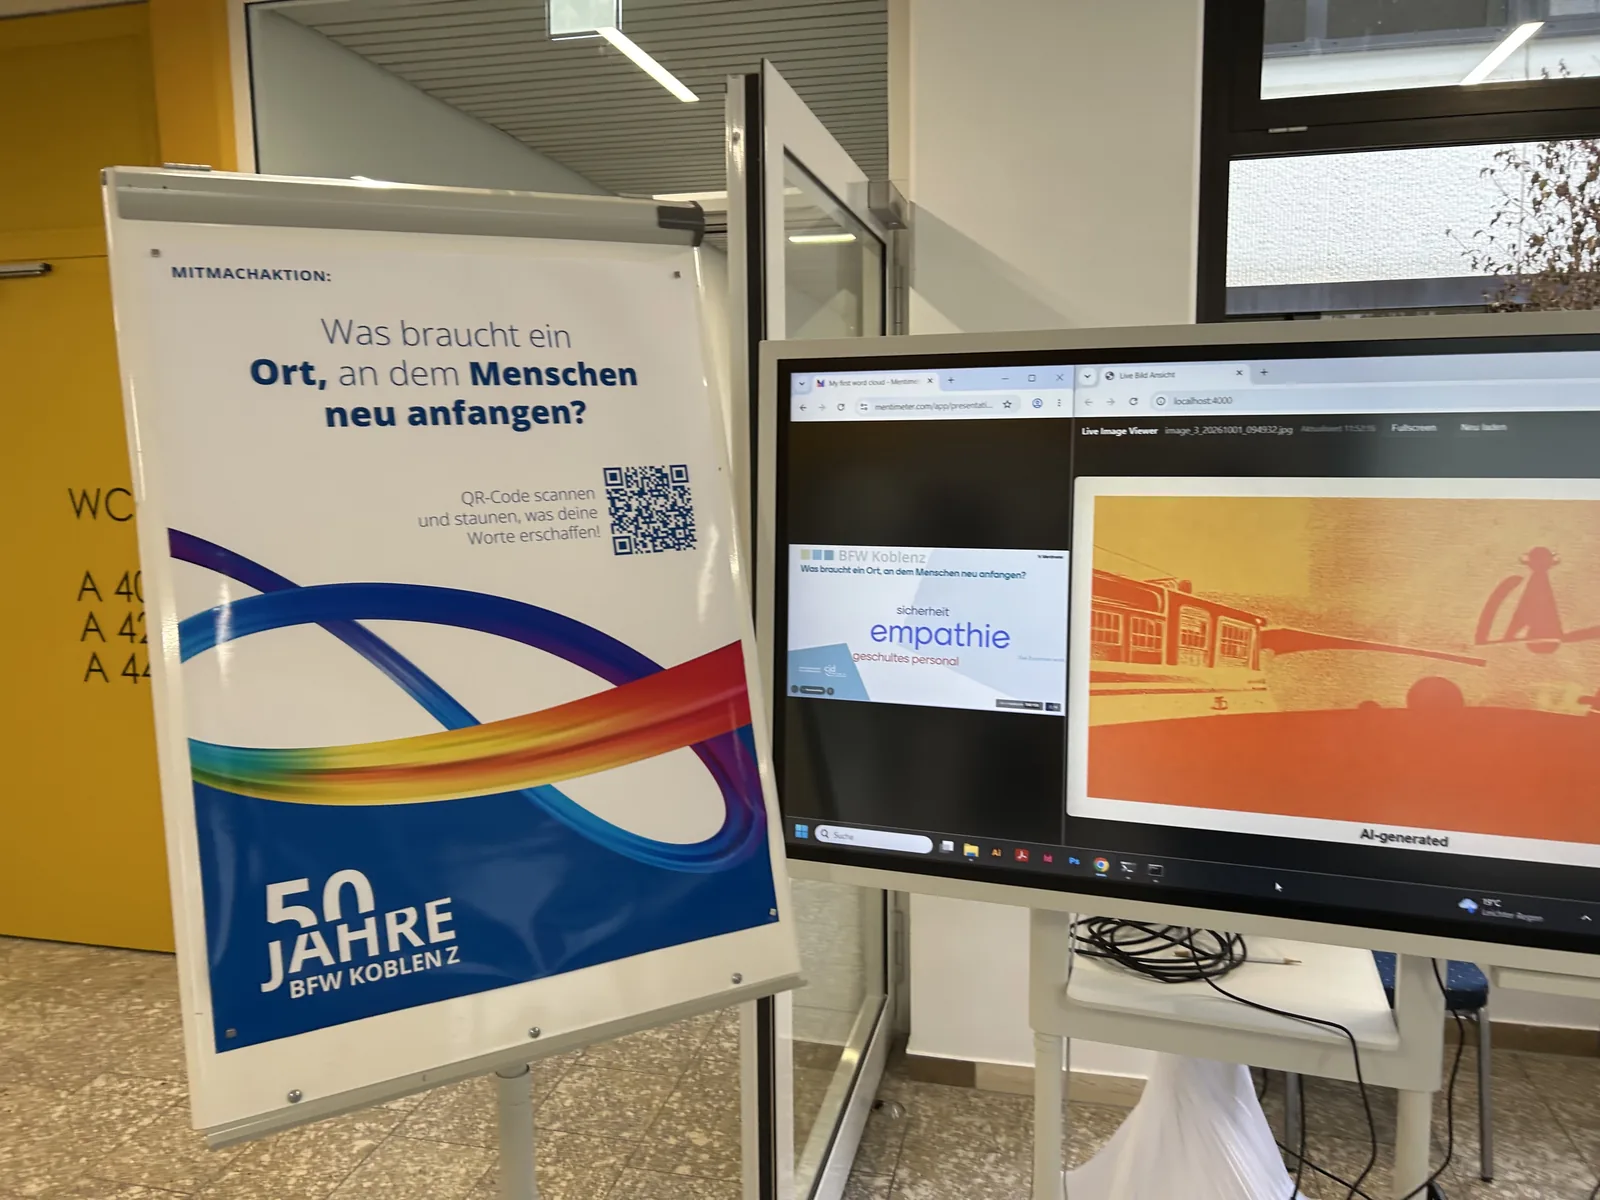
Der Zugang lief über einen QR-Code am Plakat. 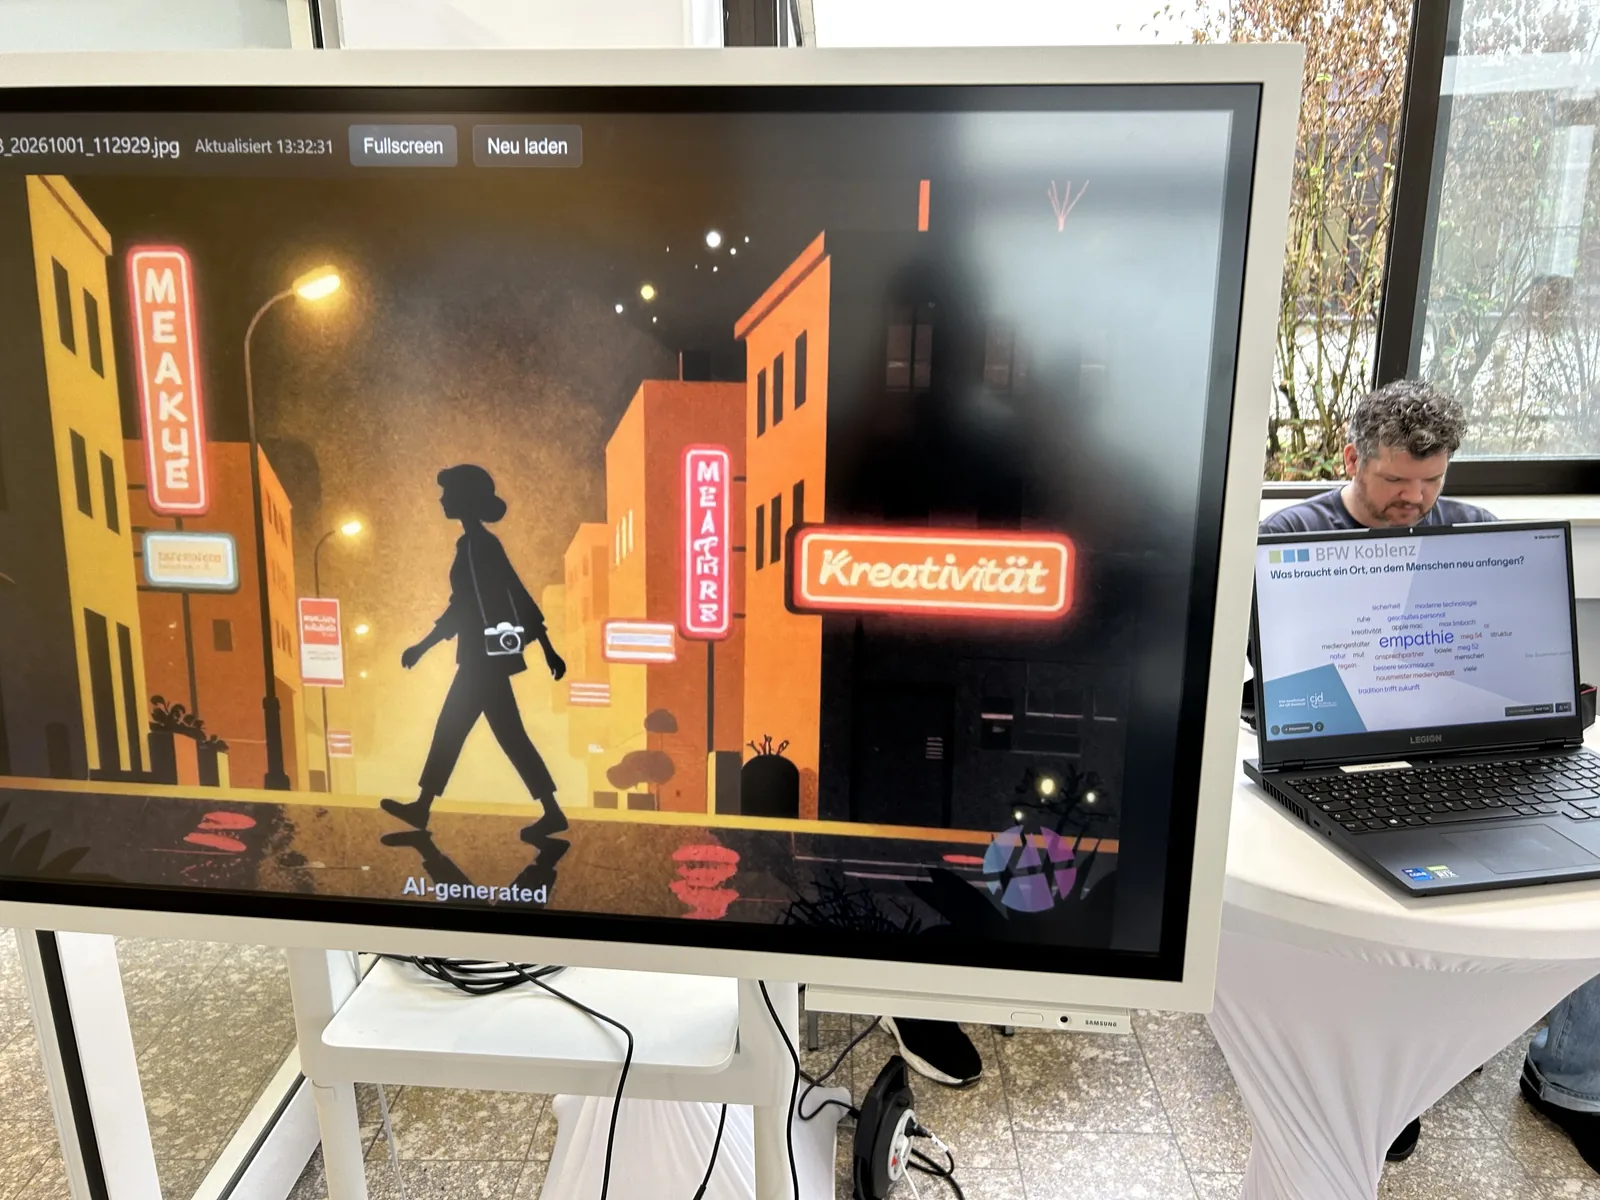
Aus einem eingereichten Wort wurde eine Neonschrift. 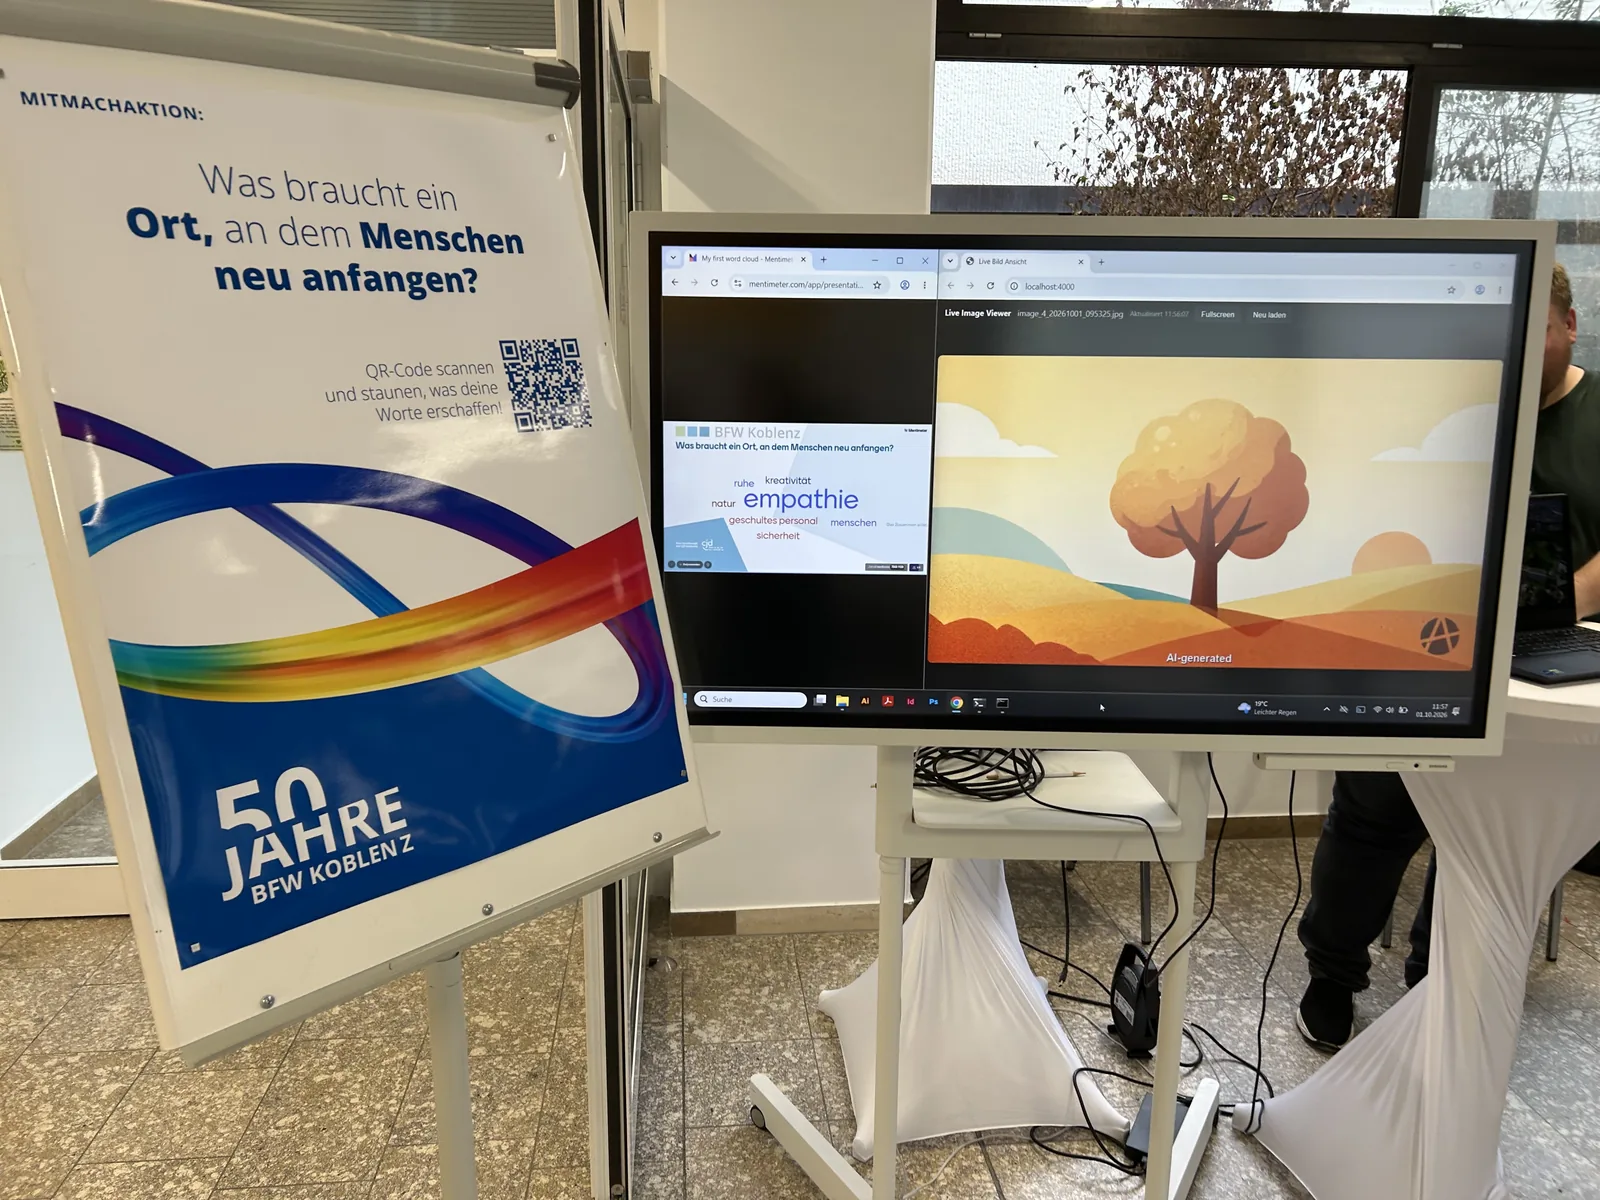
Links die Sammlung, rechts was daraus wurde.
Architektur
Lokale Inferenz
Vollständig auf Apple Silicon über MLX. Kein Cloud-Zwang, keine fremde API im Pfad.
Idle Thinker v2
Ein eigenes kleines Netz über Tätigkeiten, Stimmungen und bisherige Themen bestimmt, was sie tut, wenn niemand schreibt.
Eigenes Gedächtnis
RAG-System auf LanceDB — Langzeitkontext über Gespräche und Projekte hinweg.
Desktop-App
Tauri mit Next.js-Oberfläche: Monaco-Editor, Terminal und alle Bereiche in einem Fenster.
Web-Portal
PHP/MySQL mit Polling-Architektur — kein offener Port am Rechner, kein Tunnel nach außen.
Demo & Screenshots
Mira stand am Ende des Stegs, wo das Holz unter ihren Schritten nachgab wie müde Knochen. Der Leuchtturm von Velur blinkte im immer gleichen Rhythmus, als hätte er nichts von der Nacht mitbekommen, die hinter ihr lag …