VIDAhof e.V.
克莱沃附近一家动物收容所的网站——作为半成品的既有项目接手,并做到了完成。对 openM!nded 而言,这里也是这套工作方式能被核对的地方:模型的那部分成果,就在页面上。
前往:vidahof.de ↗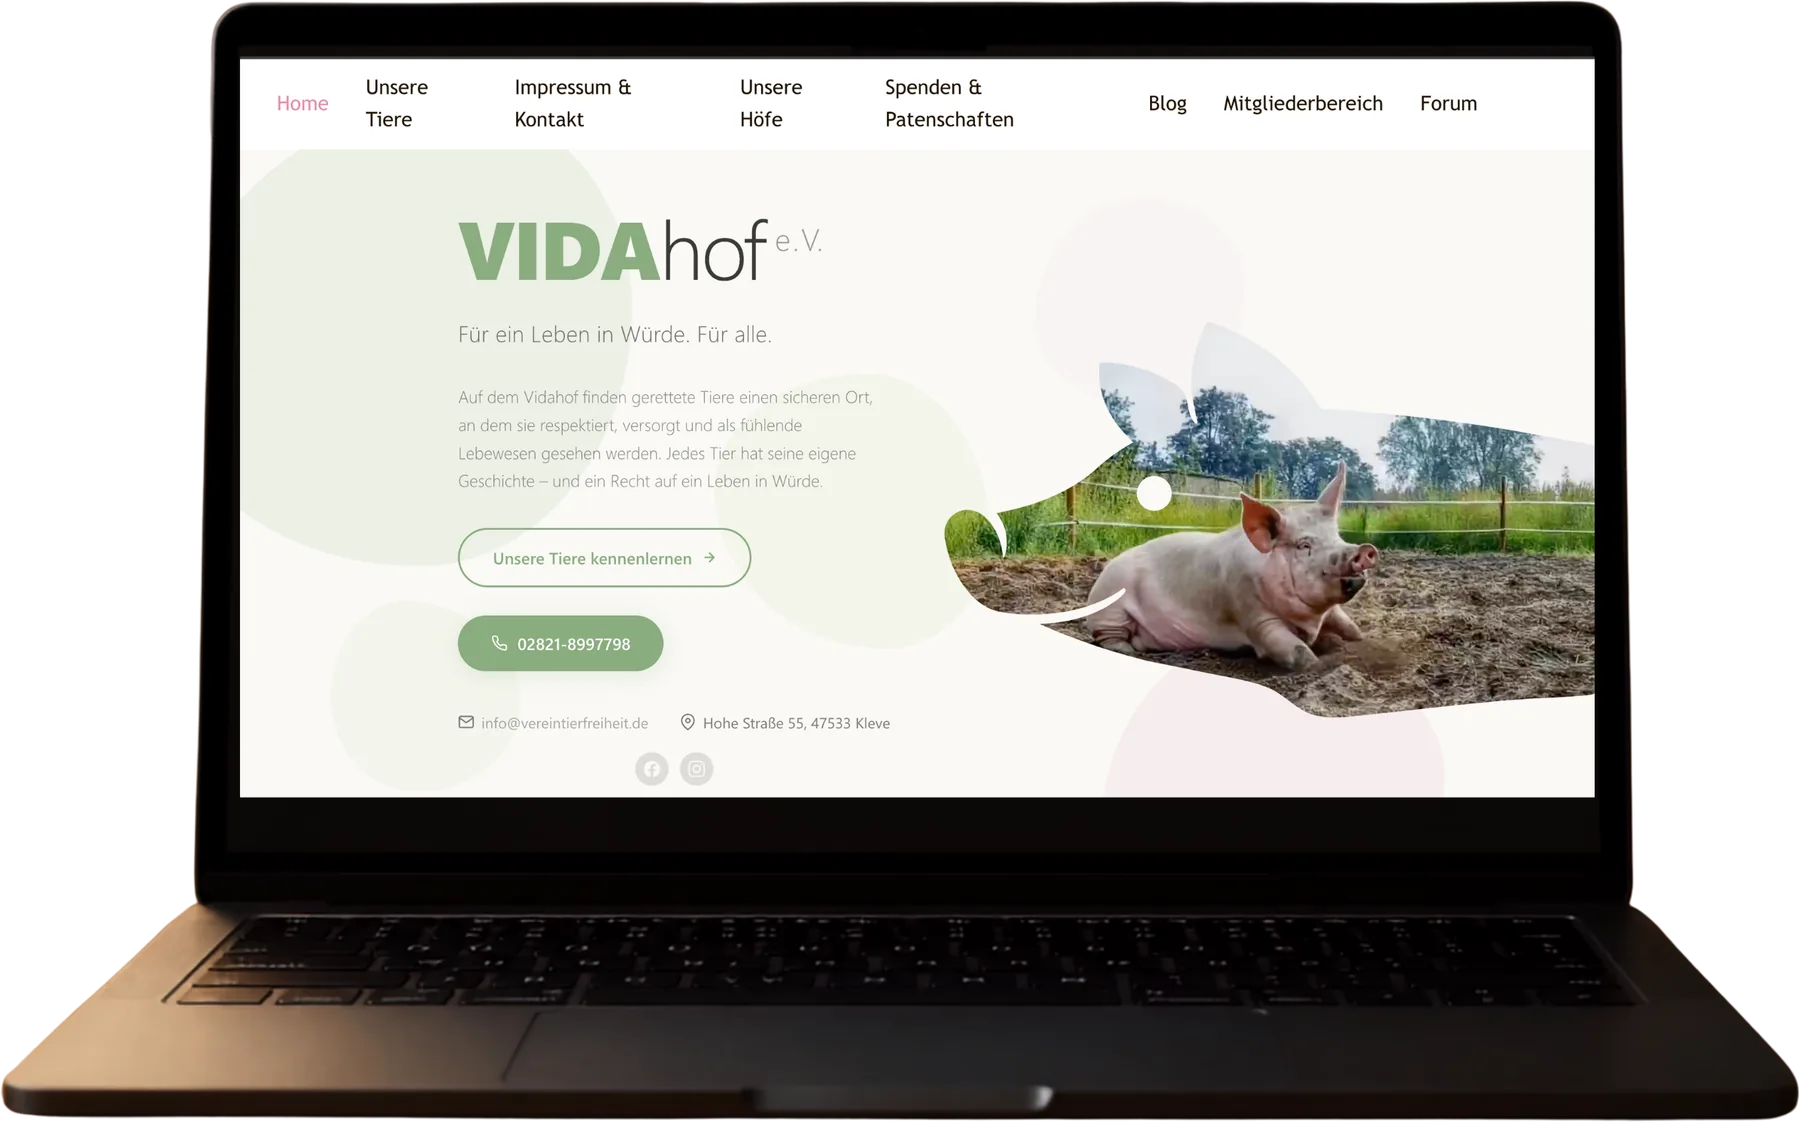
一个现有的项目,不是一张白纸。
协会在克莱沃附近经营三个农场,收留了约 130 只获救动物,并获认定为动物保护的学习场所。因此网站要做的不只是提供信息:它要争取认养与捐助,逐一介绍每只动物,还要承载一个社群——带注册与仪表盘的会员区、论坛、捐助通道。
这个网站最初是在我当时的雇主那里开始的,并且从未在那里完成。我接手了这个项目:别人写的代码、别人做的自定义模块,外加一个把页面以 JSON 形式存在数据库里的页面构建器。因此新的子页面我特意做成了朴素的 UIkit 文章,而不是用构建器——后台用起来不那么舒服,但真出问题时修得动。
协会不为此付钱。这是故意的。
繁琐的活儿是模型干的
- 148条替代文本,已在页面上线
- 200+机器自动裁剪的照片
- 0那些离开了电脑的图片
每种动物都有一个简介,每个简介配一张照片。每张照片都需要一段替代文本和一个能适配两种不同布局的裁剪图。加上大约130种动物以及农场、团队和博客图片,这涉及几百个细小的决策。每一个单独拿出来都不怎么样——但合在一起却耗费数日时间。
这部分交给了 A!ley——本来就跑在这里的那个模型。没有云端服务,没有上传,协会的数据也不会落到外人手里。
148个替代文本
每张图片都有描述性的替代文本,与其他内容一起在同一个运行中生成。它们就那样显示在页面上——我并没有手动编写它们。
每个个人资料的描述
每只动物都有一个字段,描述照片里看到了什么。这直接来自图片本身,而不是协会的资料——所以正是之前有人必须手动输入的那部分。
超过 200 张照片的构图角度
动物照片、团队和农场拍摄:模型为每张照片确定合理的裁剪区域,并以坐标形式输出。这些数据被原样保留——我没有进行任何二次裁剪。
博客配图
博客文章中的插图来自本地图像生成,并在元数据中进行了相应标注。动物照片当然是真实的摄影作品。
还是会被反读。模型给建议,我做决定——只是决策只需几分钟,而写作需要几天。
为什么这不仅仅是便利
几天来的努力工作
一个市政旅游项目:120多个实物展品需要上到网上。交付的东西就是这类项目中常见的——质量参差不齐的手机照片,还有散落在各家厂商邮件里的信息。
每件作品两个切片:带底座和铭牌的全景,以及仅针对物体的特写。然后把信息手写到图纸上,自己打好替代文本(Alt-Texte),上传,然后下一件。我坐了几天——作为实习生。如果让别人做的话,那是拿钱的开发工时,最后会出现在客户账单上。
一整晚的堆栈运行
三个步骤中的两个在 VIDAhof 运行得完全一样:裁剪变成坐标问题,而替代文本是在同一个过程中生成的。第三个——将来自邮件、笔记和数据表的非结构化文本转换为整洁的架构,而不是复制——是同样的机制,只是应用于文本而非图像。
剩下的就是审查。而这才是真正的核心工作:一个错误的建议,几秒钟就会暴露出来。从头到尾自己写一遍,只需要几分钟——两百次。
这在实践中意味着什么
时间
这个堆栈在无人监管下运行,因为它不阻塞任何东西:模型本来就是加载好的。我自己的时间花在了查看上,而不是在干活。
费用
常规工作按正常时薪计费,并列入客户账单。在这里它被省略了,且不影响任何内容。
均匀度
第二百张图的裁剪比例与第一张完全一致。就在这个点上,人会可靠地掉以轻心——包括我。
数据保护
没有上传。对于一个拥有捐赠者数据、动物档案和员工照片的协会来说,这并非次要问题,而是前提。
哪里能看到协作的成果
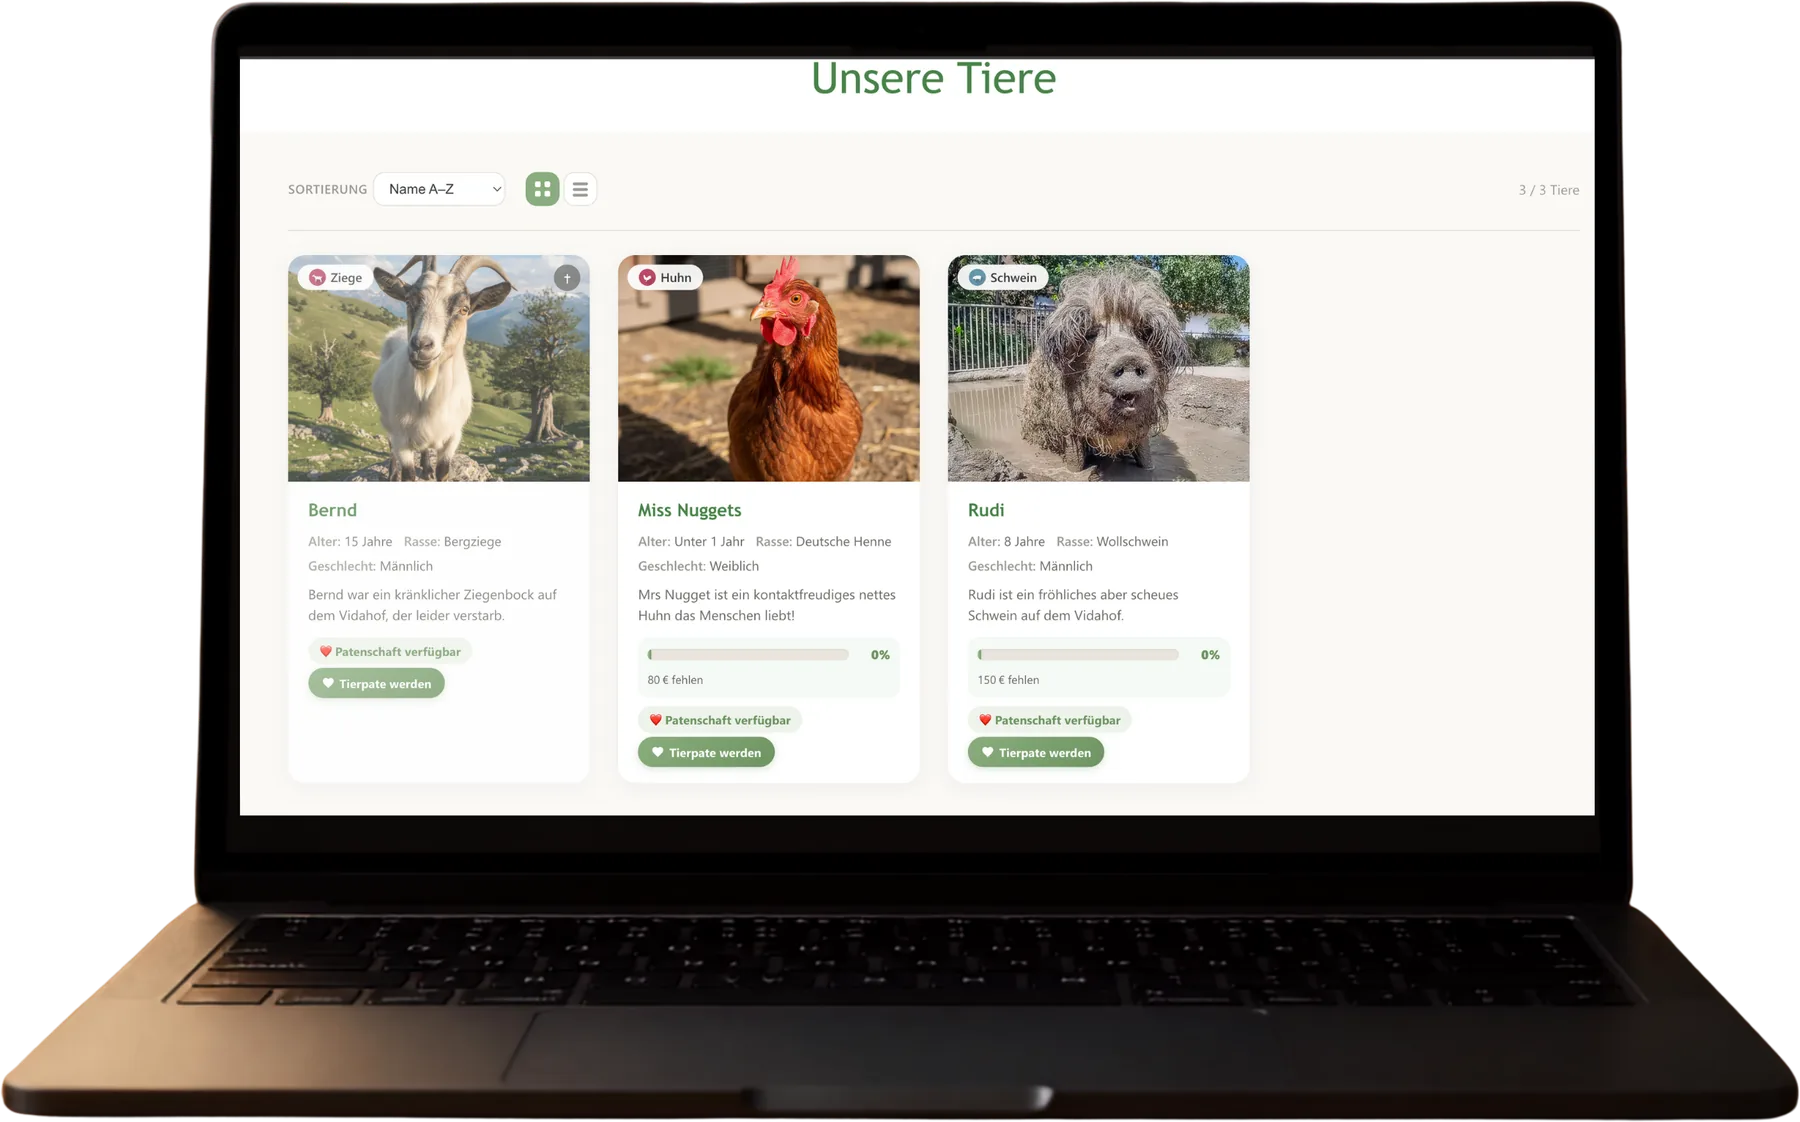
所有动物的概览——这里每个片段遵循相同的比例,非常划算。 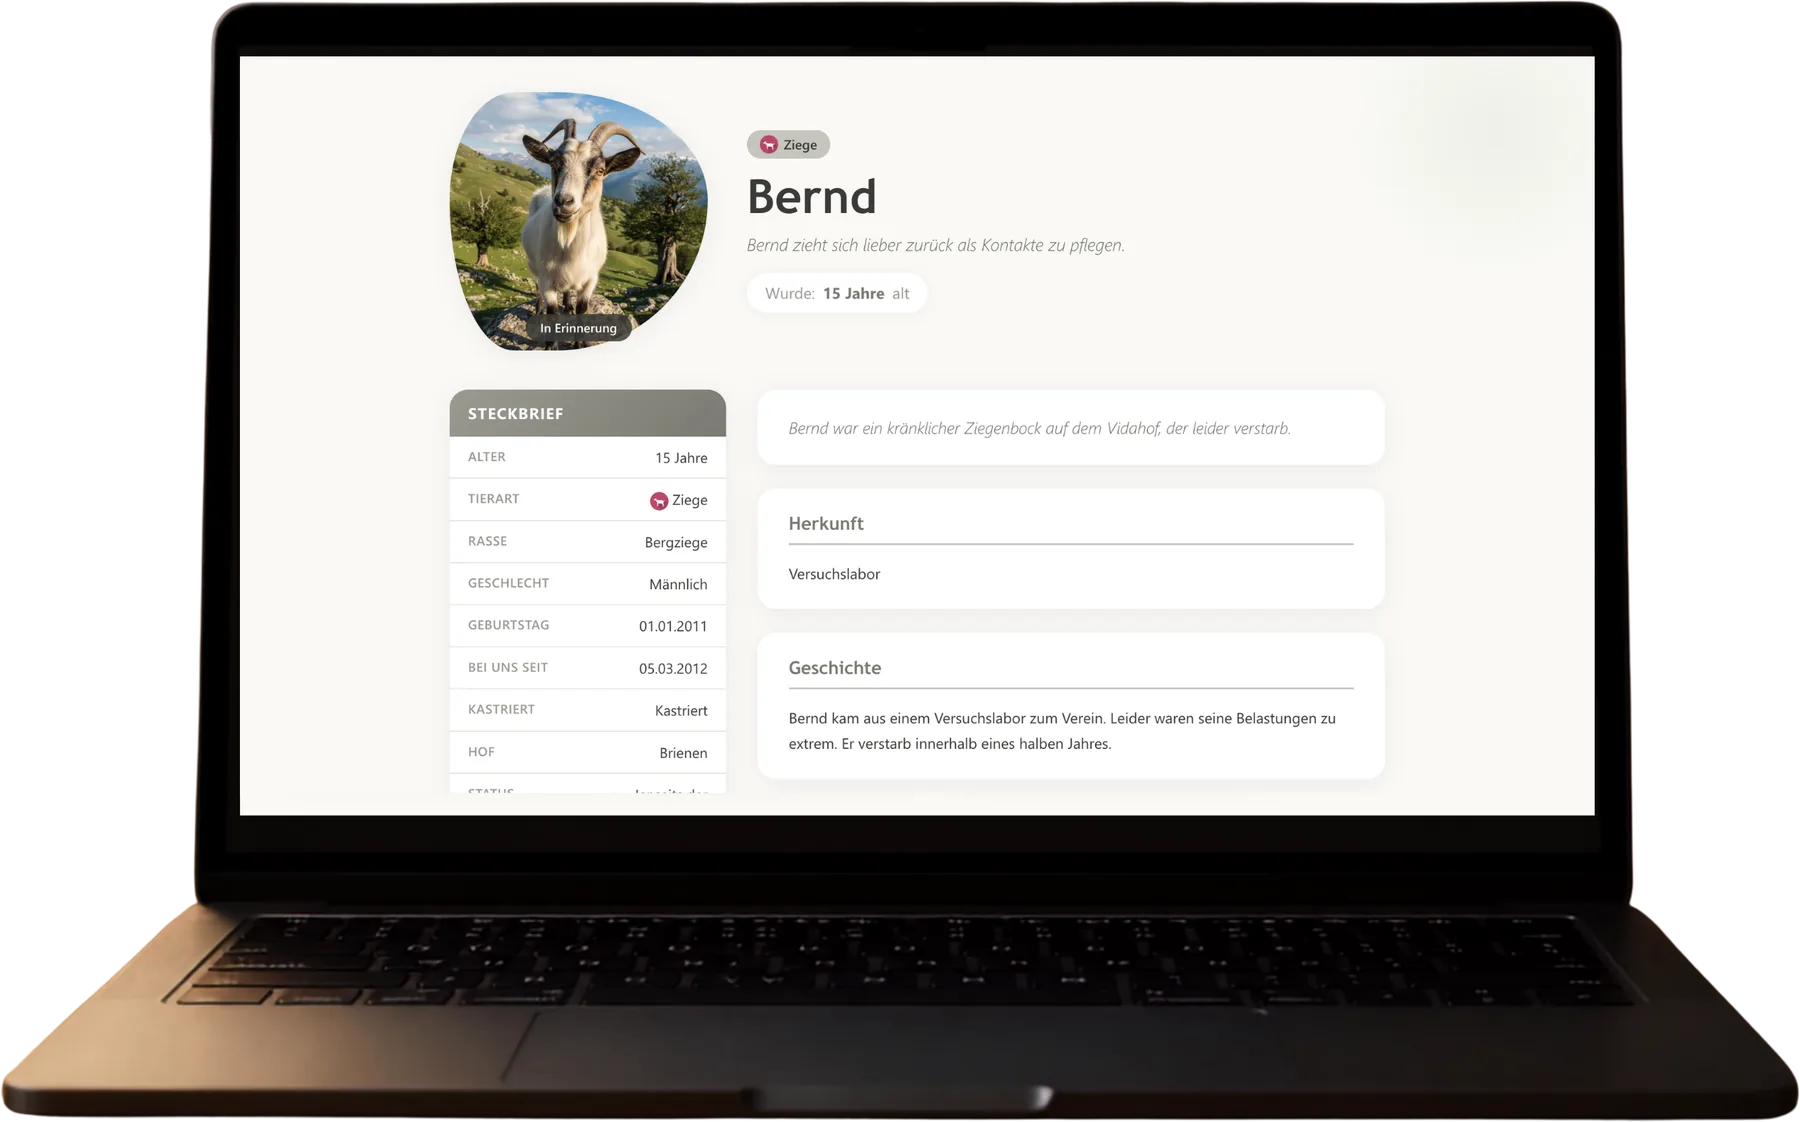
一张个人简介。其中的视觉描述来自图像分析,而协会的故事则是从历史中提取的。